เข้าใจแพตเทิร์นสถาปัตยกรรมผ่านภาพที่ขยับได้
ไดอะแกรม SVG ขยับได้ที่เล่าทีละขั้นว่าแต่ละแพตเทิร์นทำงานยังไง ทั้ง architecture style, cloud design pattern, auth flow, design pattern ของ GoF และอัลกอริทึมที่ควรรู้ สำหรับ solutions architect และนักพัฒนา เลือกแพตเทิร์นที่สนใจ กดเล่น หรือค่อย ๆ ดูไปทีละขั้นก็ได้
ข้อความในภาพเป็นภาษาอังกฤษ เพราะส่วนใหญ่เป็นชื่อ class โค้ด กับตัวเลขอยู่แล้ว
- 206 แพตเทิร์น
- 0 รอทำ
- 17 หมวด
สถาปัตยกรรมแอปพลิเคชัน
ภาพใหญ่ของระบบ: จะแบ่งระบบเป็นส่วน ๆ ยังไง แล้วแต่ละส่วนคุยกันแบบไหน
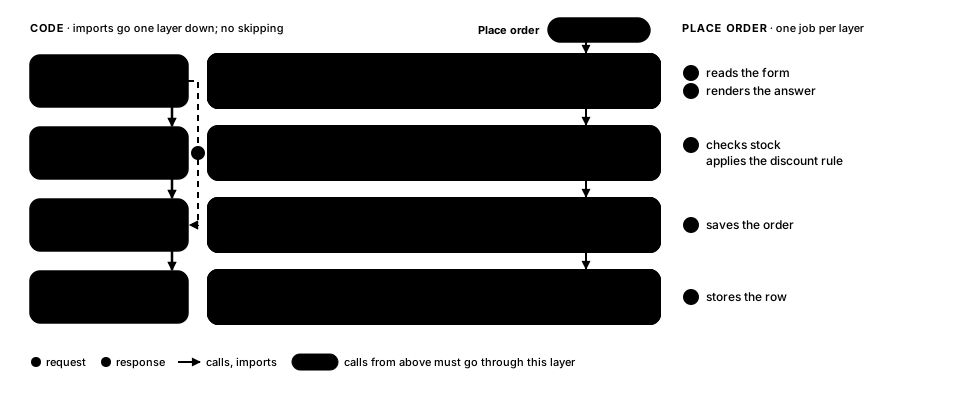
Layered (N-Tier)
แบ่งเป็น layer ของ presentation, business และ data แต่ละ layer เรียกได้แค่ layer ที่อยู่ถัดลงไปชั้นเดียว
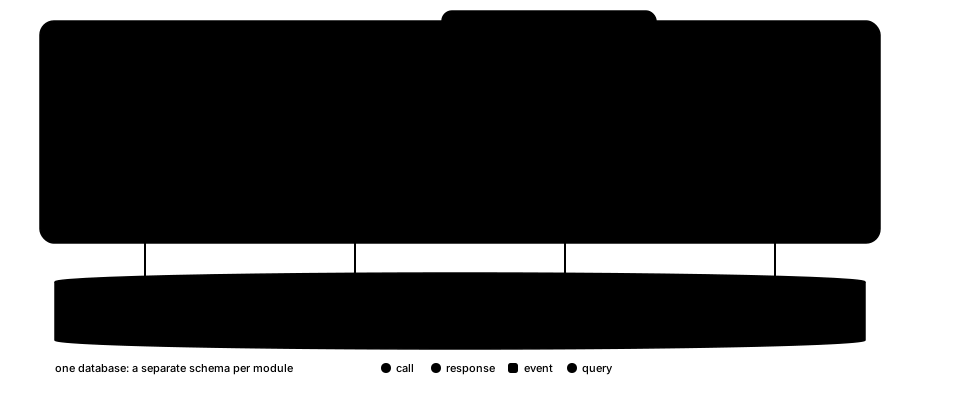
Modular Monolith
deploy เป็นก้อนเดียว ข้างในประกอบจาก module ที่แบ่งขอบเขตกันเข้มงวด และคุยกันผ่าน interface ที่ประกาศไว้ชัดเจน
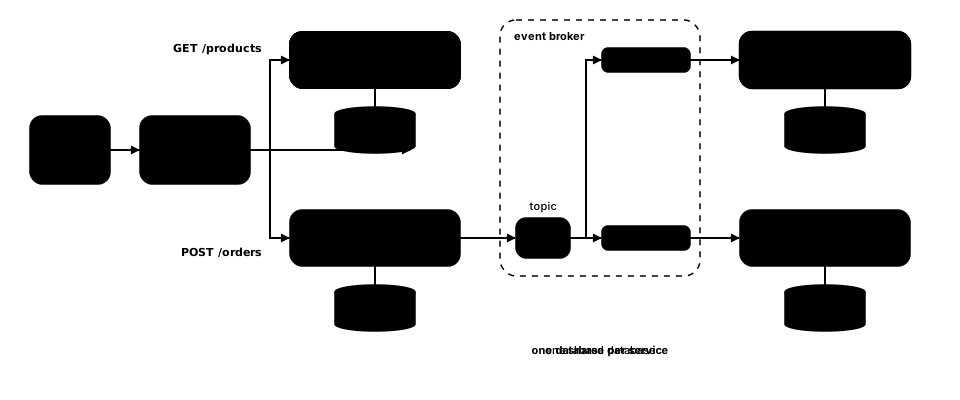
Microservices
service เล็ก ๆ ที่ deploy แยกกันได้ แต่ละตัวเป็นเจ้าของ business capability หนึ่งอย่างพร้อมข้อมูลของตัวเอง
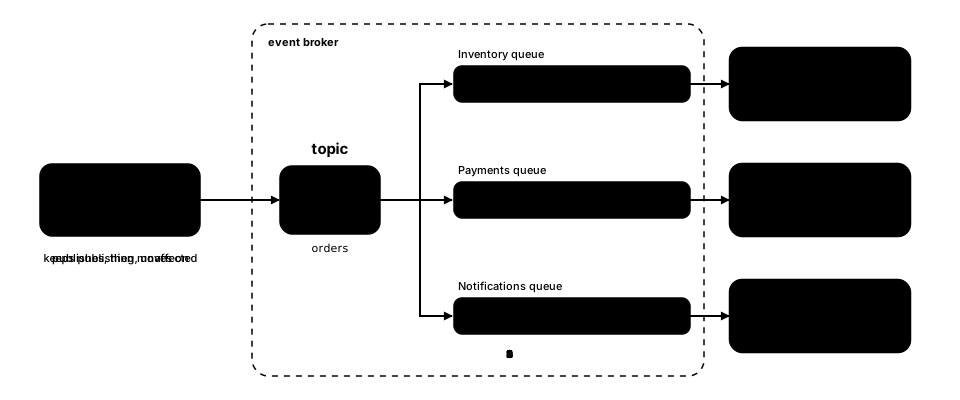
Event-Driven Architecture
producer publish event ไปที่ broker แล้ว consumer กี่ตัวก็ได้จะรับไปทำต่อตามจังหวะของตัวเอง
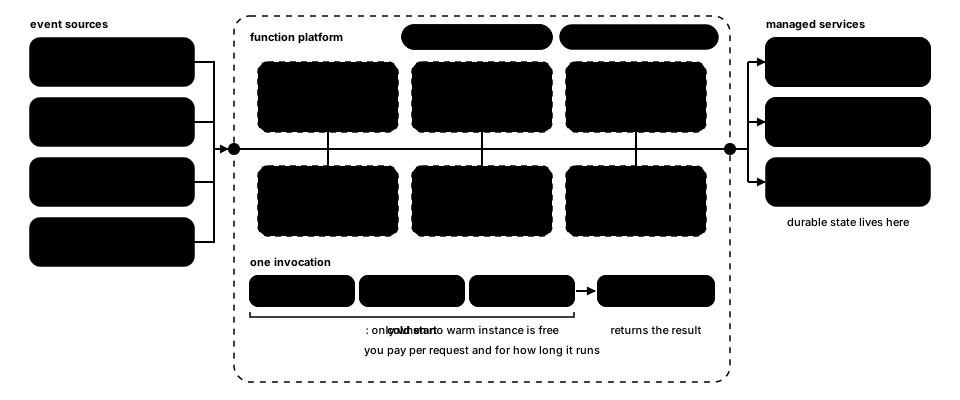
Serverless (Functions)
function เริ่มทำงานทุกครั้งที่มี event เข้ามา scale out ได้เอง และ scale to zero ตอนไม่มีงาน
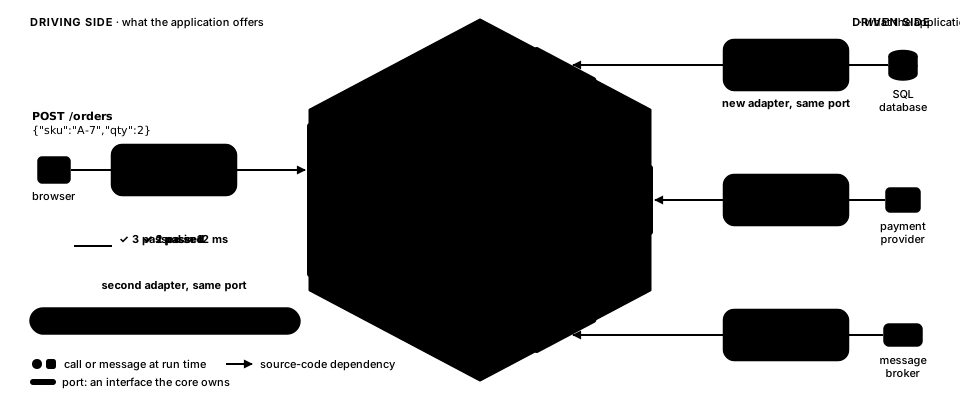
Hexagonal (Ports & Adapters)
domain logic อยู่ตรง core ส่วน UI, ฐานข้อมูล และ queue ก็เสียบเข้ามาผ่าน port กับ adapter
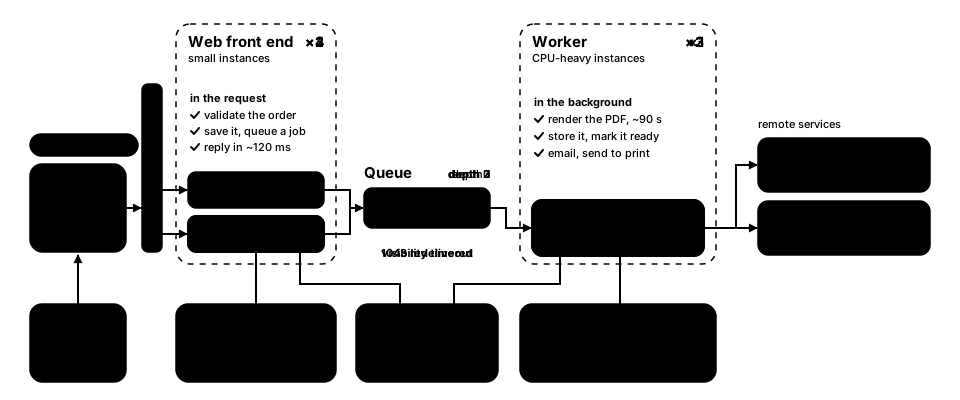
Web-Queue-Worker
web front end ส่งงานช้า ๆ ต่อให้ worker เบื้องหลังผ่าน queue
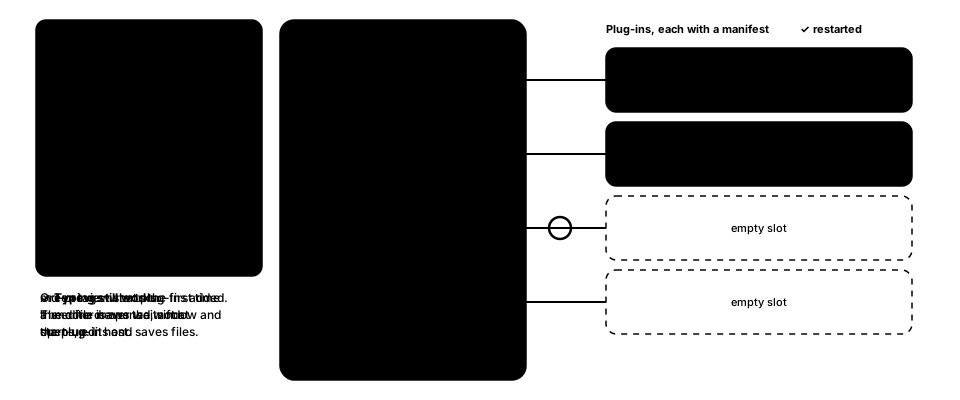
Microkernel (Plug-in)
core system ที่เล็กแค่เท่าที่จำเป็น แล้วเพิ่มความสามารถด้วย plug-in module ที่เป็นอิสระต่อกัน
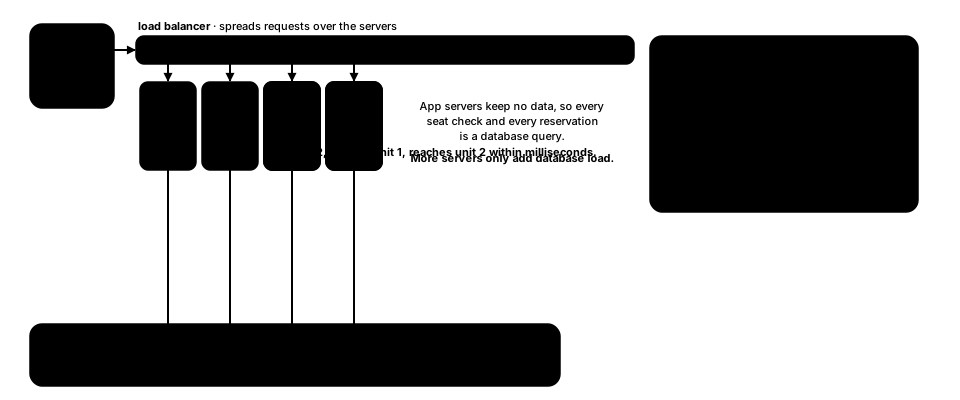
Space-Based
processing unit ใช้ in-memory data grid ร่วมกัน เลยเอาฐานข้อมูลออกจาก hot path ได้
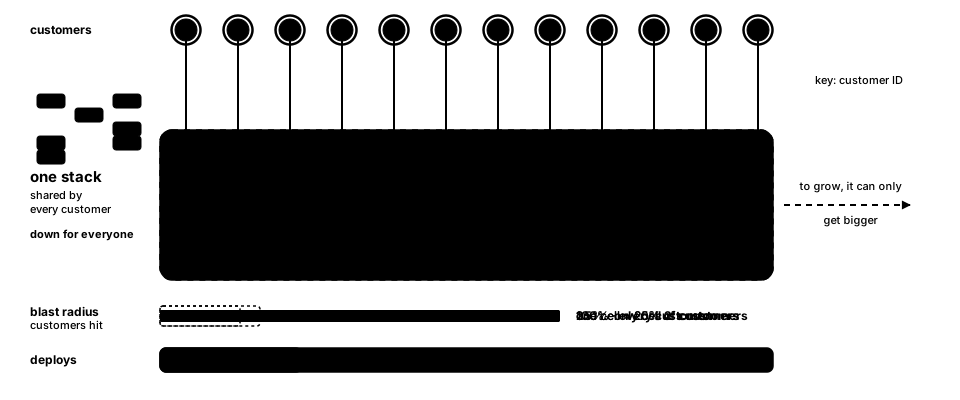
Cell-Based Architecture
cell หลายชุดที่แยกขาดจากกันและเหมือนกันทุกอย่าง อยู่หลัง router บาง ๆ ตัวเดียว ช่วยจำกัด blast radius ไม่ว่าจะพังแบบไหน
โครงสร้างพื้นฐานบน Cloud
workload ไปรันที่ไหน แล้วจะ scale ให้ทัน ไม่ล่ม และกู้คืนได้เมื่อเกิดเหตุใหญ่ยังไง
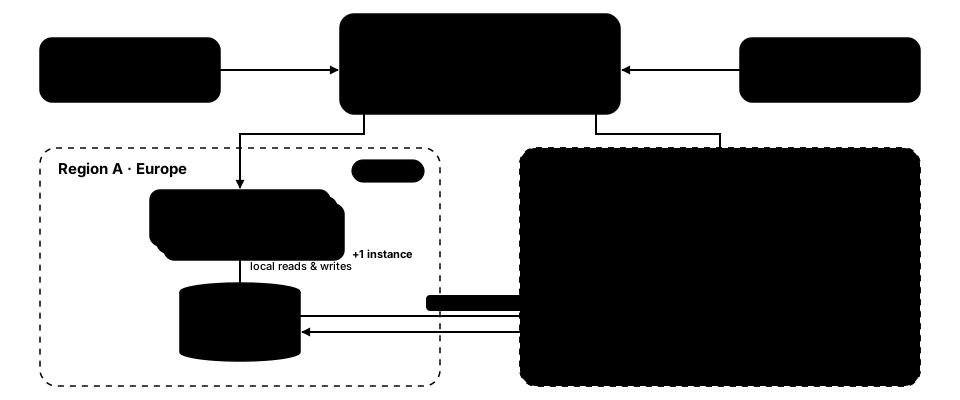
Multi-Region Active-Active
ให้บริการผู้ใช้จากหลาย region พร้อมกัน ถ้า region ไหนล่มก็ย้าย traffic ออกไป
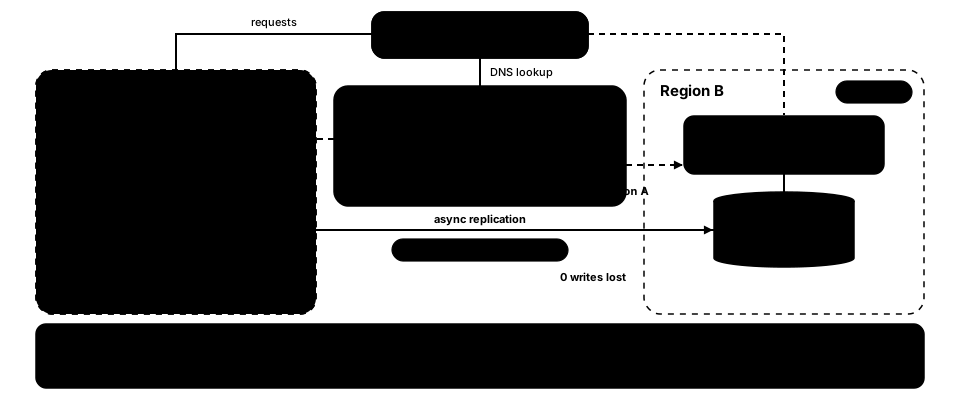
Active-Passive Failover
พอ primary region ล่ม ก็ promote region สำรองแบบ warm standby ขึ้นมาแทน
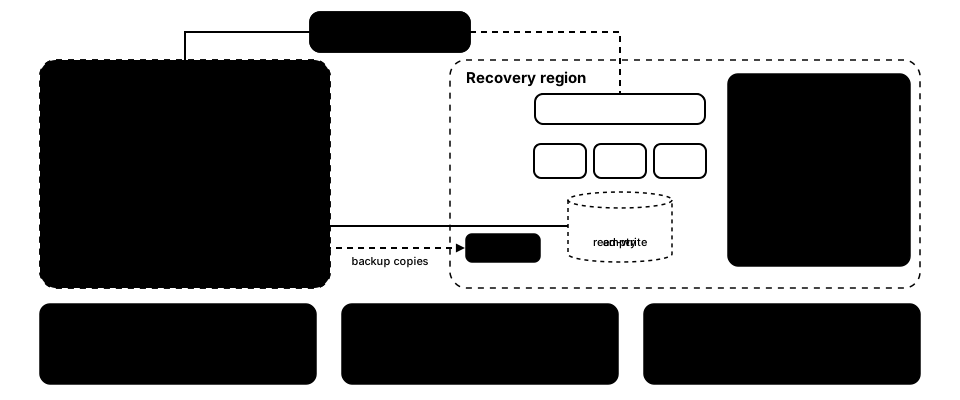
Disaster Recovery Strategies
Backup & restore, pilot light, warm standby และ active-active: เลือกว่าจะยอมจ่ายแค่ไหนเพื่อแลกกับ RTO และ RPO
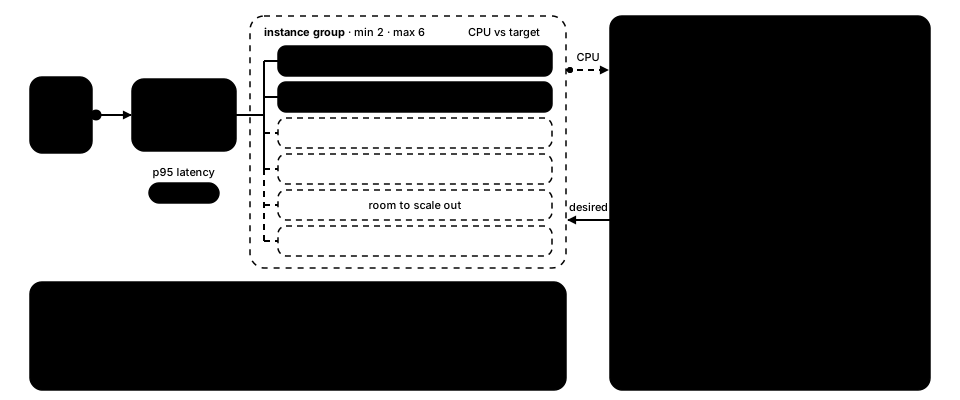
Autoscaling
เพิ่มและลด instance ให้อัตโนมัติตามโหลดที่ขึ้น ๆ ลง ๆ
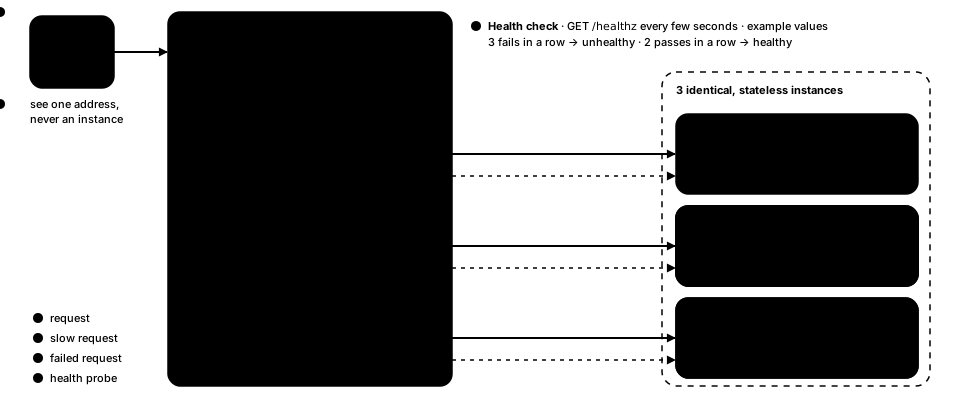
Load Balancing
กระจาย request ไปให้ instance ที่ healthy และเลิกส่งไปหาตัวที่ unhealthy
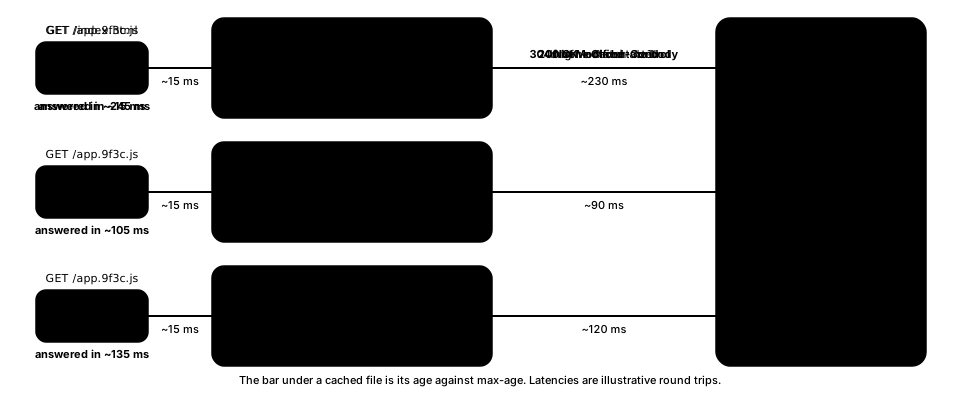
CDN & Edge Caching
ส่ง static content จาก edge location ที่อยู่ใกล้ผู้ใช้ มีแค่ cache miss ที่วิ่งไปถึง origin
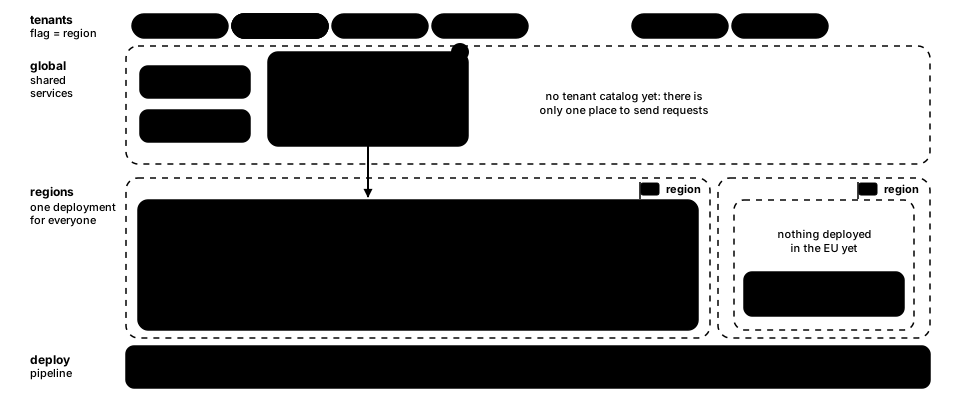
Deployment Stamps
deploy stack ทั้งชุดเป็นหลาย ๆ สำเนาที่แยกเป็นอิสระต่อกัน แต่ละสำเนาดูแล tenant กลุ่มหนึ่ง
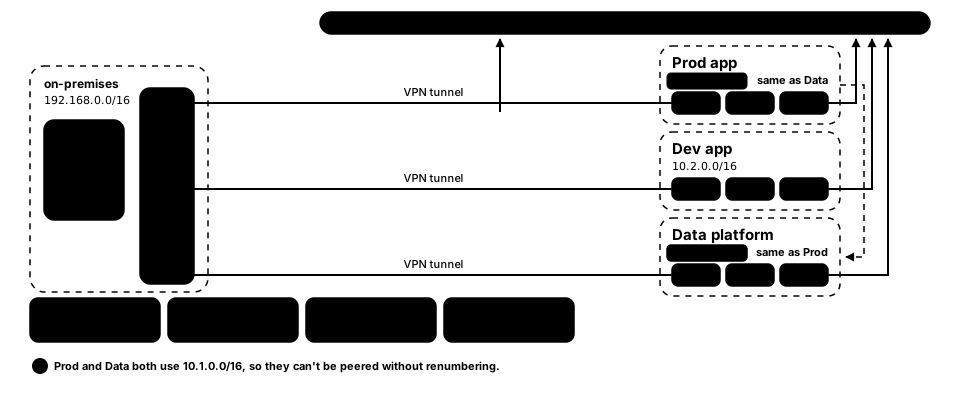
Hub-and-Spoke Network
เอา service ที่ใช้ร่วมกันและ egress ไว้ใน hub network ตรงกลาง ส่วน workload อยู่ใน spoke ที่ peer เข้ากับ hub
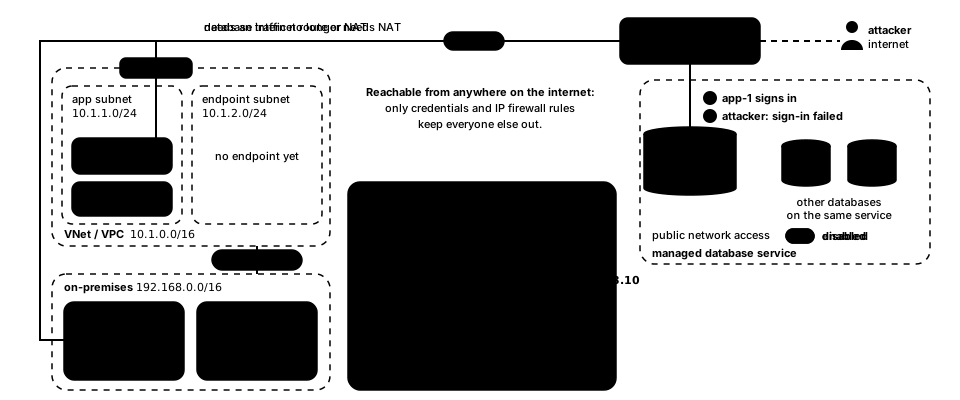
Private Endpoints
เข้าถึง managed cloud service ผ่าน private IP ไม่ต้องวิ่งผ่าน public internet
การยืนยันตัวตนและสิทธิ์การเข้าถึง (Auth)
flow ของ authentication และ authorization: ใครกำลังเรียกเข้ามา แล้วเขาทำอะไรได้บ้าง
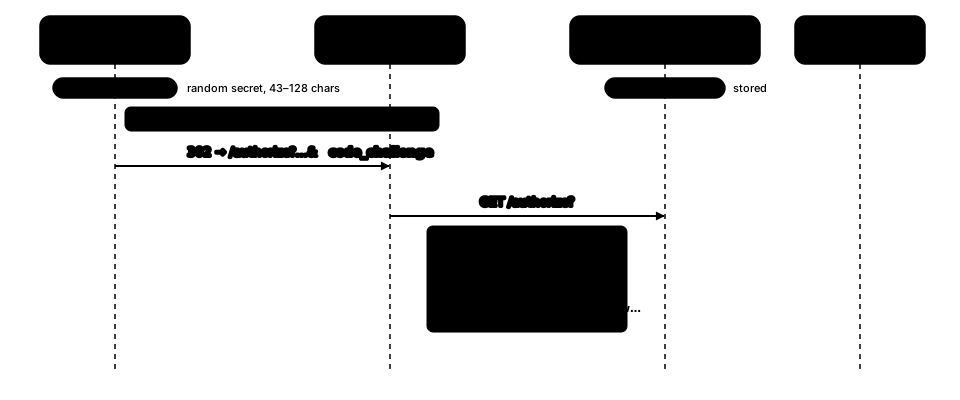
OAuth 2.0 Authorization Code + PKCE
flow เข้าสู่ระบบมาตรฐานของเว็บแอป แอปมือถือ และ single-page app: code มาทาง browser ส่วน token มาทาง back channel
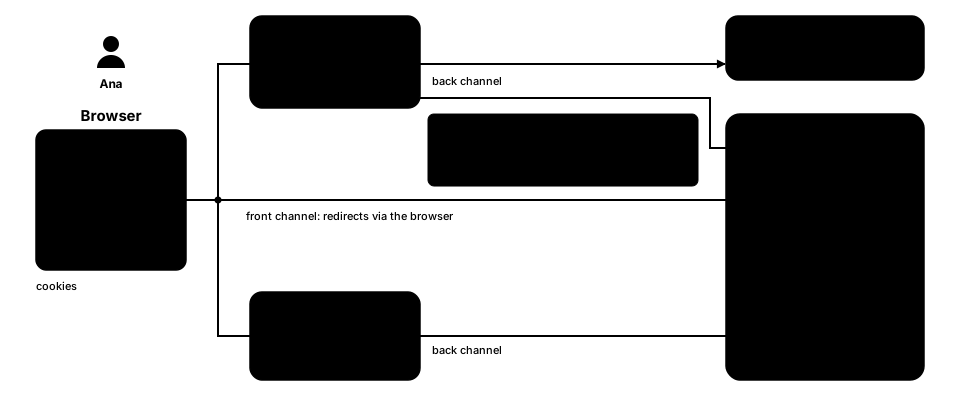
OpenID Connect (OIDC)
ID token ที่เพิ่มเข้ามาบน OAuth 2.0 คอยบอกแอปว่าใครเป็นคนเข้าสู่ระบบ
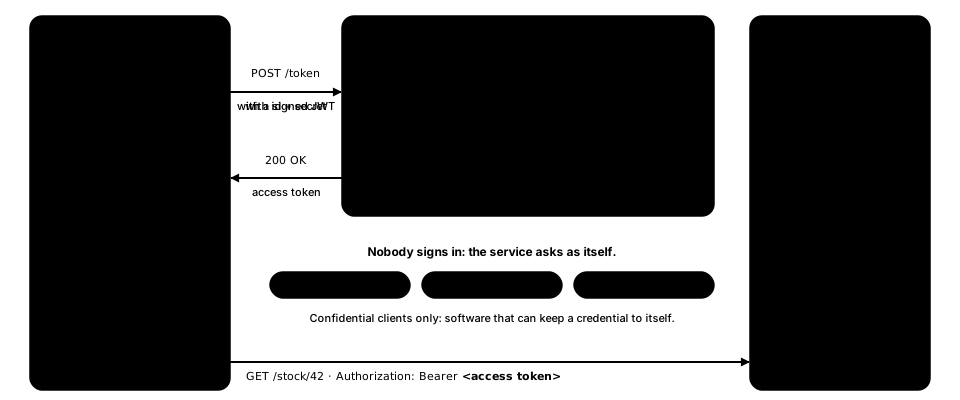
OAuth 2.0 Client Credentials
access token สำหรับงาน machine-to-machine ที่ไม่มีผู้ใช้มาเกี่ยวเลย
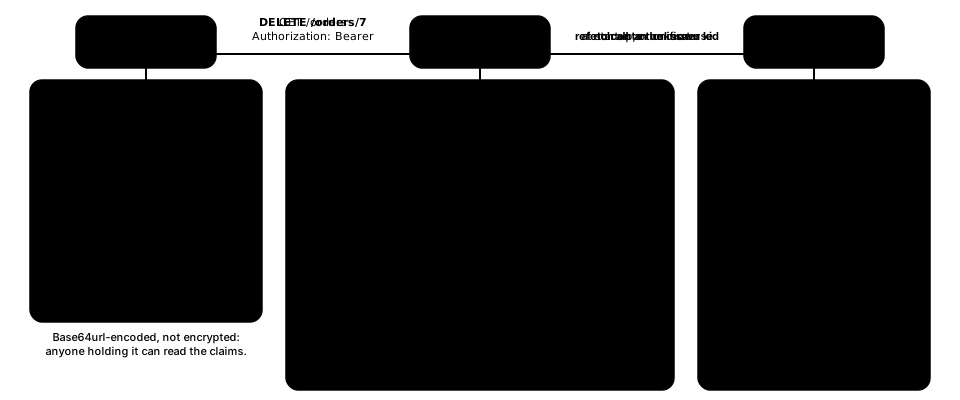
JWT Validation
API ตรวจ signature และ claim ของ token เองในเครื่อง ด้วย public key ของ issuer ที่ cache ไว้ (JWKS)
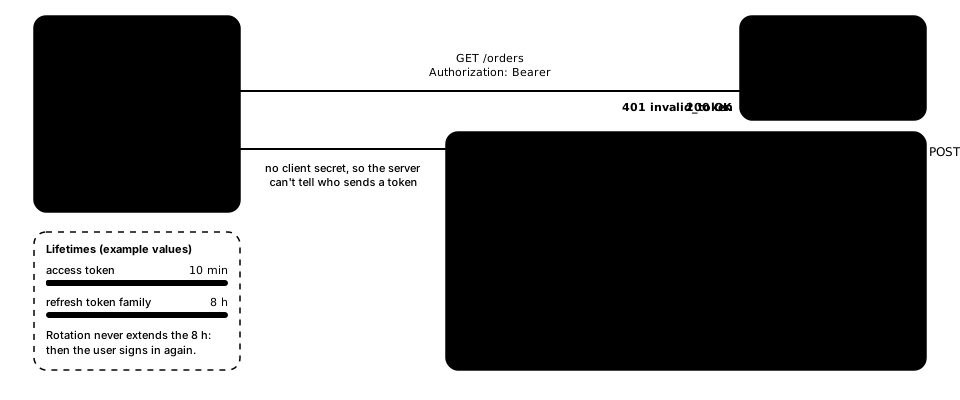
Refresh Token Rotation
access token อายุสั้น refresh token ที่ใช้ได้ครั้งเดียว และถ้าจับได้ว่ามีการใช้ซ้ำก็ revoke ทั้ง family
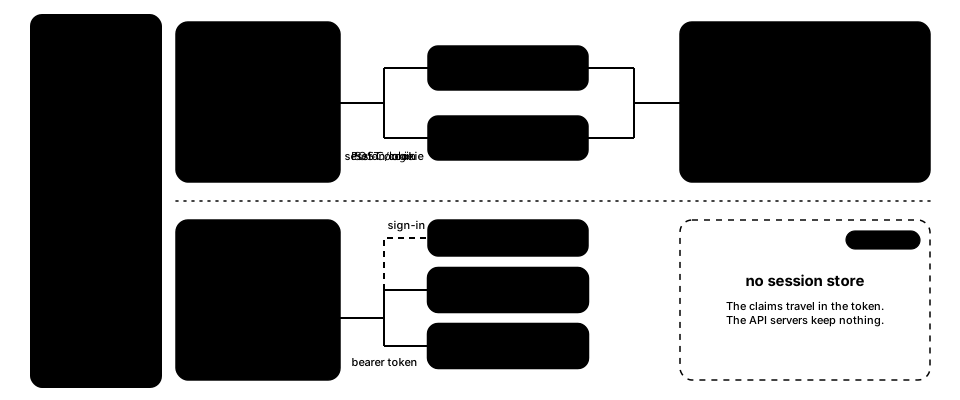
Sessions vs Tokens
session ฝั่ง server เทียบกับ token ที่มีข้อมูลครบในตัว: state อยู่ที่ไหน และ revoke ยังไง
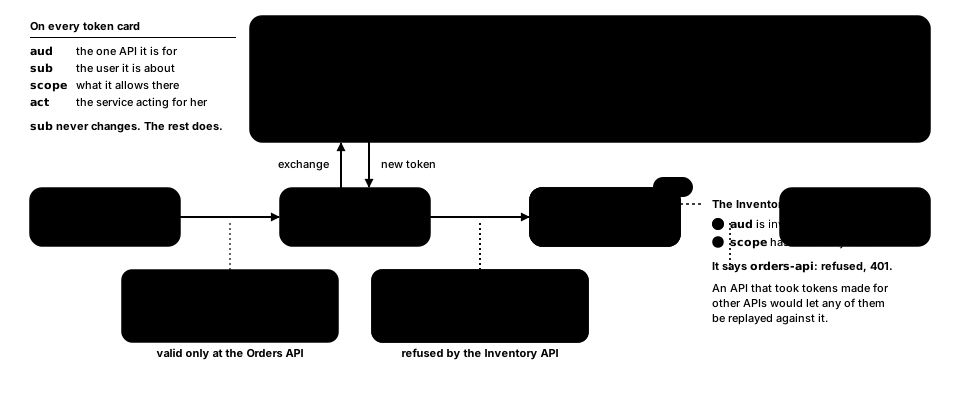
Token Exchange (On-Behalf-Of)
เอา token ของผู้ใช้ที่ส่งเข้ามาไปแลกเป็น token ที่ขอบเขตแคบลง ก่อนเรียก downstream API
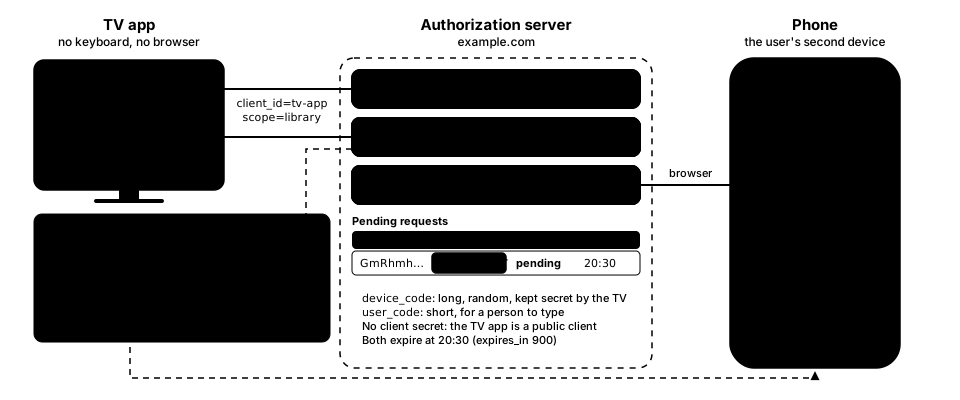
Device Authorization Grant
เข้าสู่ระบบบน TV หรือ CLI โดยกดอนุมัติ code สั้น ๆ บนมือถือ
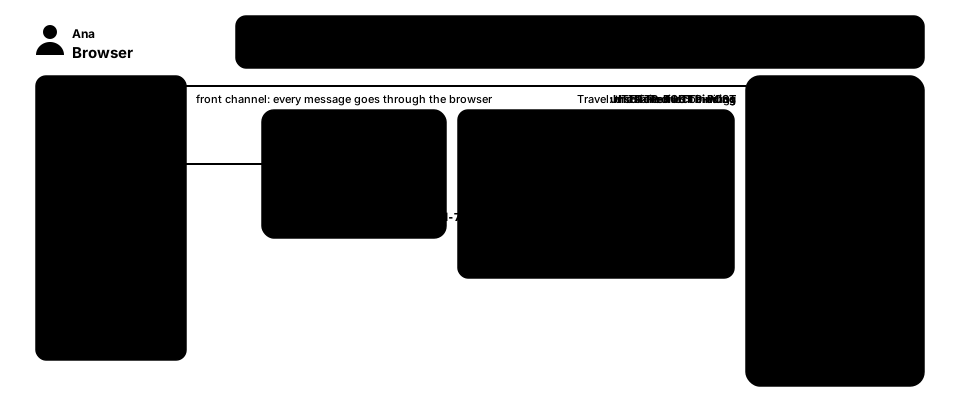
SAML 2.0 Single Sign-On
SSO ในองค์กร: identity provider POST assertion ที่ sign แล้วไปให้แอปผ่าน browser
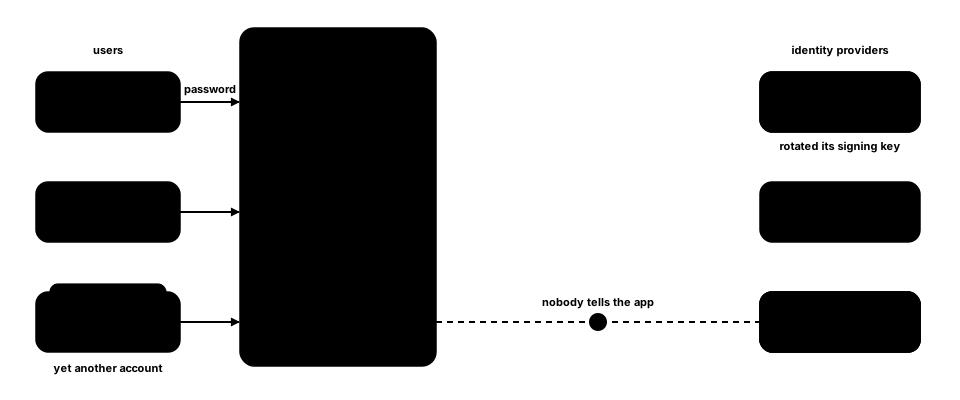
Federated Identity
ให้ identity provider ภายนอกเป็นคนยืนยันตัวตนผู้ใช้ ส่วนแอปเชื่อ token ที่ provider ออกให้
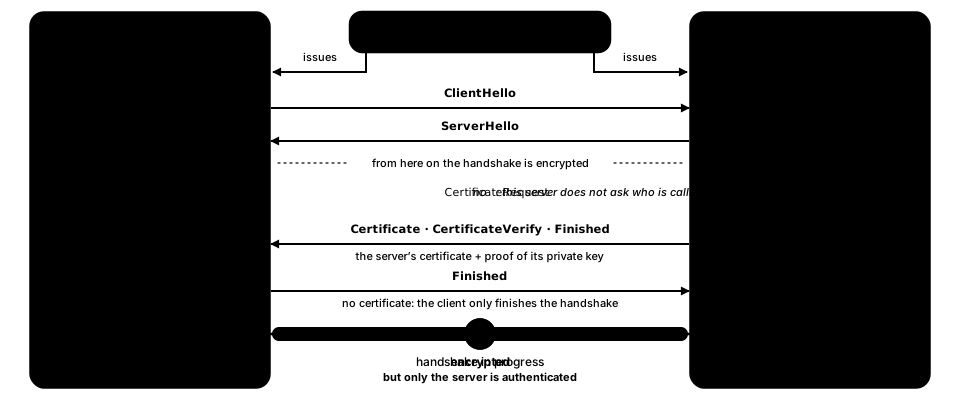
Mutual TLS (mTLS)
ทั้ง client และ server ยื่น certificate ของตัวเอง ทุก connection เลยยืนยันตัวตนได้ทั้งสองทาง
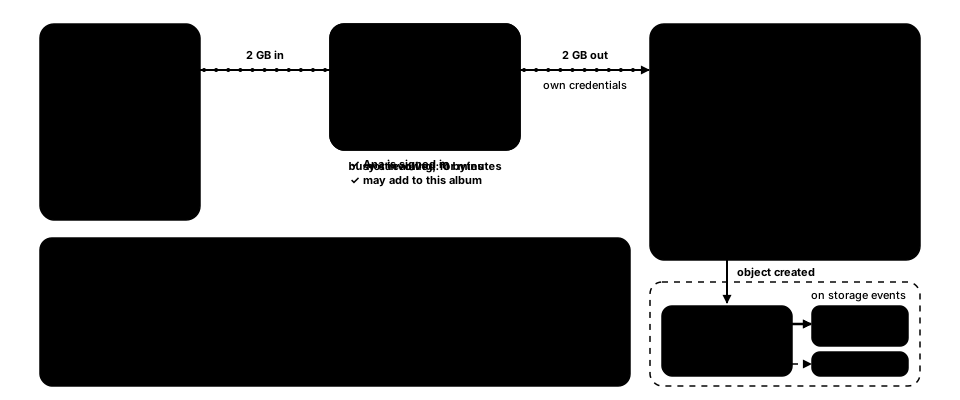
Valet Key
ให้ URL อายุสั้นที่ขอบเขตแคบกับ client เอาไว้อ่านหรือเขียน storage ได้ตรง ๆ
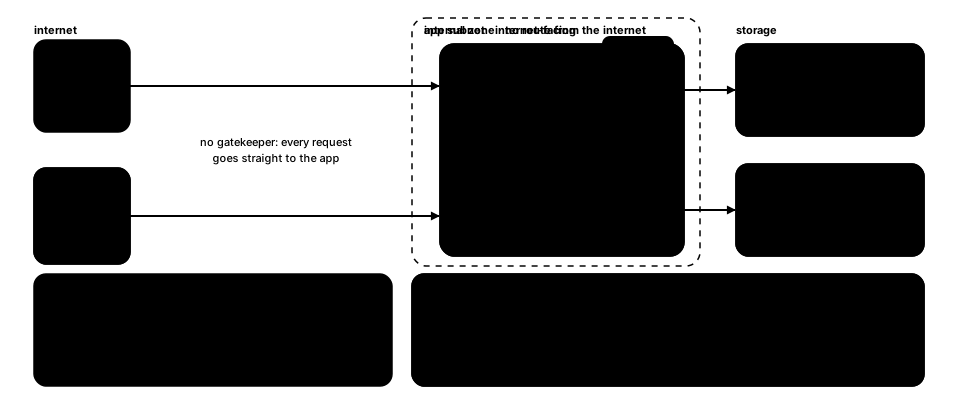
Gatekeeper
broker ที่ harden ไว้แล้ว คอยตรวจและ sanitise request ก่อนจะไปถึง trusted host
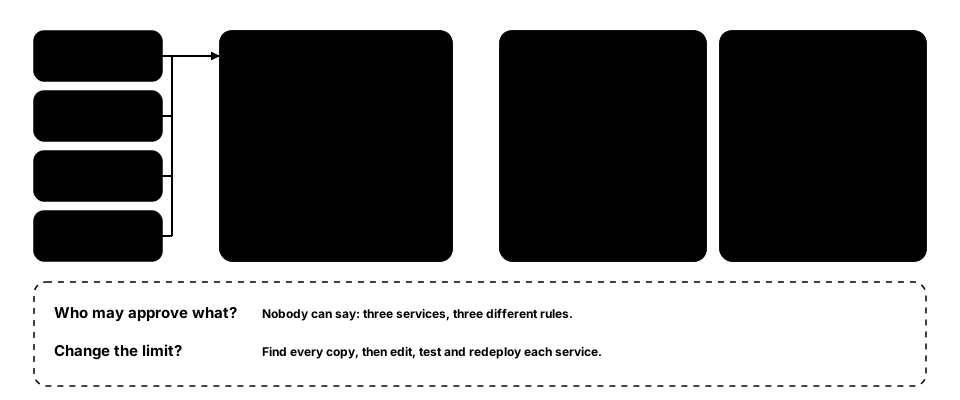
Policy-Based Authorization
service ถาม policy engine ส่วนกลางว่าจะ allow หรือ deny (RBAC, ABAC, ReBAC)
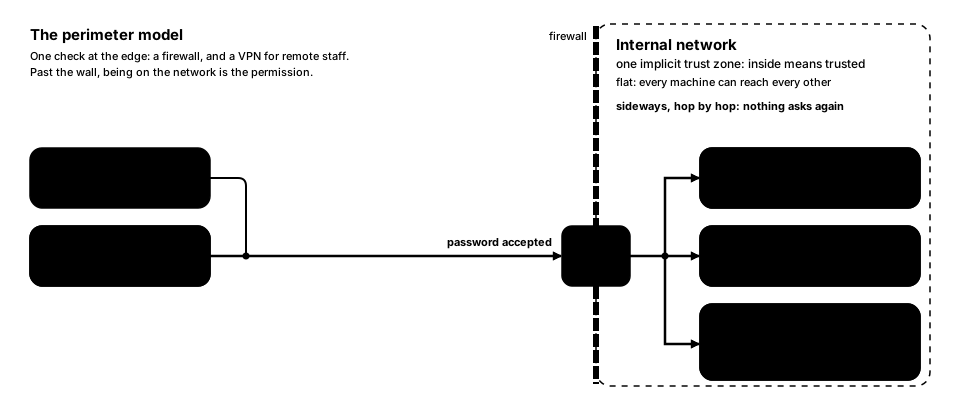
Zero Trust Access
ไม่เชื่อใครไปเองแค่เพราะอยู่ใน network ไหน: ตรวจ identity, อุปกรณ์ และ context ทุก request
API และ Edge
ประตูหน้าบ้านของระบบ: client เข้าถึง service ยังไง และงานที่ทุก service ต้องทำควรไปอยู่ตรงไหน
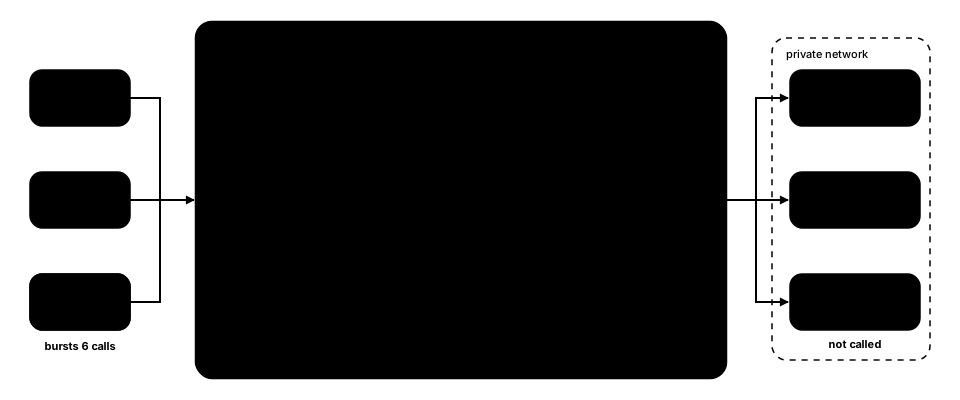
API Gateway
ทางเข้าทางเดียวที่คอยยืนยันตัวตน ทำ rate limit และ route การเรียกไปที่ backend service
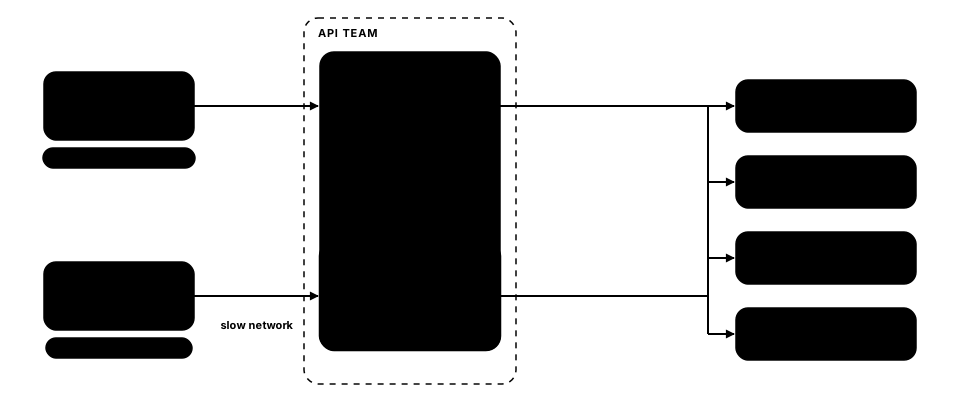
Backends for Frontends (BFF)
backend แยกเฉพาะสำหรับ client แต่ละประเภท ทำมาให้ตรงกับที่ UI นั้นต้องใช้พอดี
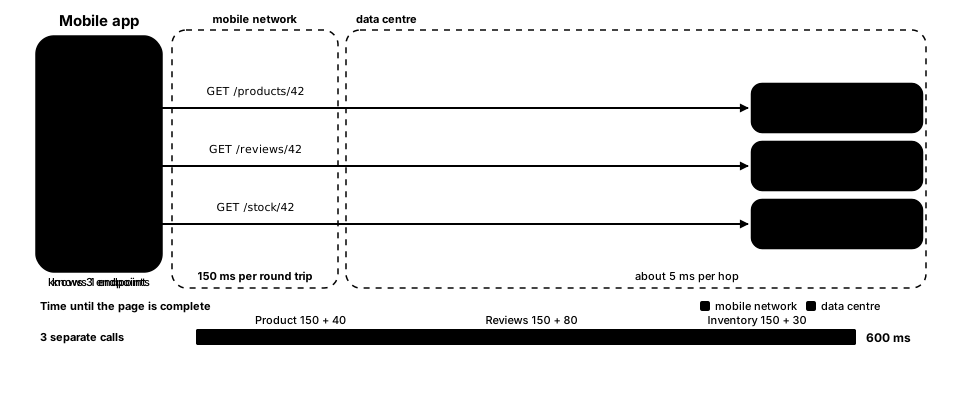
Gateway Aggregation
กระจาย request เดียวจาก client ออกไปหลาย service แล้วรวมคำตอบกลับมาเป็น response เดียว
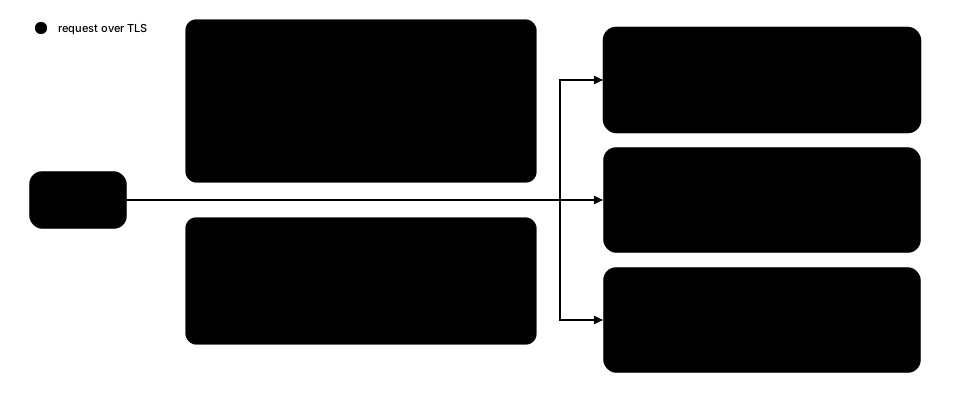
Gateway Offloading
ย้าย TLS termination, authentication และ compression ออกจากทุก service ไปไว้ที่ gateway
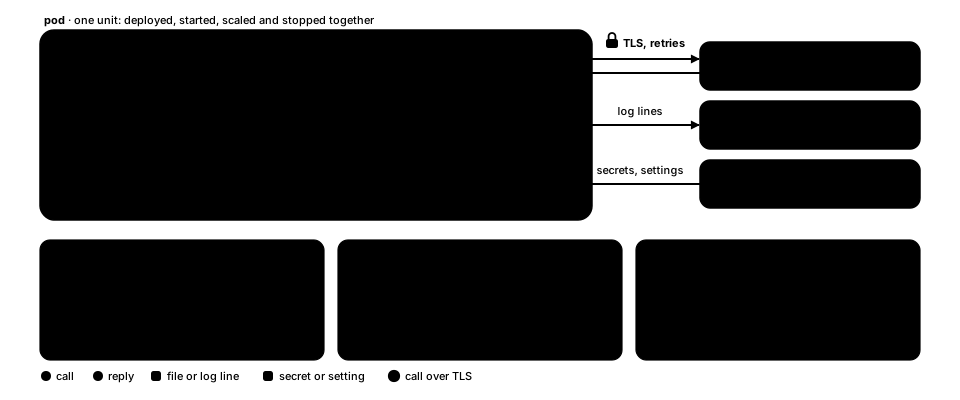
Sidecar
แยกงานเสริม (proxy, logging, config) ไปรันเป็น process ต่างหากข้าง ๆ แอป
Ambassador
proxy ที่รันแยก process คอยดูแลการเชื่อมต่อขาออก (retry, TLS, routing) แทน client
Service Mesh
sidecar proxy บวก control plane: ได้ mTLS, retry และการย้าย traffic โดยไม่ต้องแตะโค้ดแอปเลย
Webhooks
แจ้ง subscriber ด้วยการเรียก HTTP endpoint ของเขา พร้อม signature, retry และ idempotency
GraphQL Federation
subgraph จากหลาย service รวมกันเป็น graph เดียว แล้ว router ก็วางแผนว่าแต่ละ query จะไปถาม subgraph ไหนบ้าง
Messaging และการเชื่อมต่อระบบ
การคุยกันแบบ asynchronous และการประสานงานที่ต้องทำข้ามหลาย service
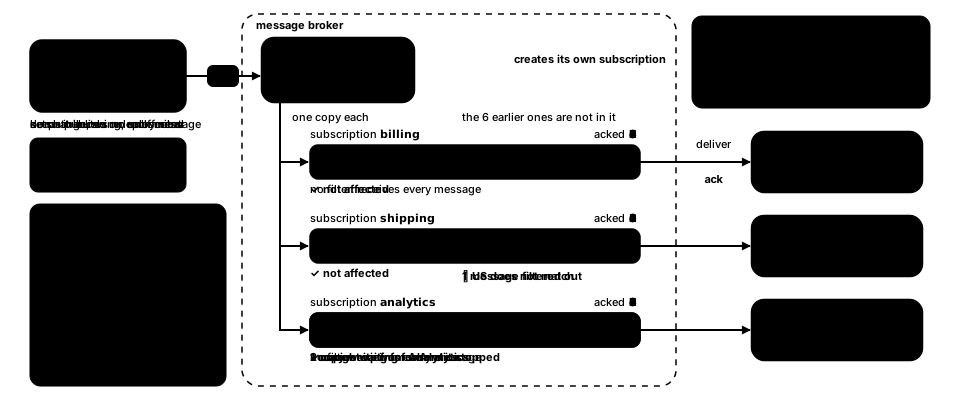
Publish-Subscribe
กระจายแต่ละ message ผ่าน topic ไปให้ subscriber ทุกตัวที่สนใจ
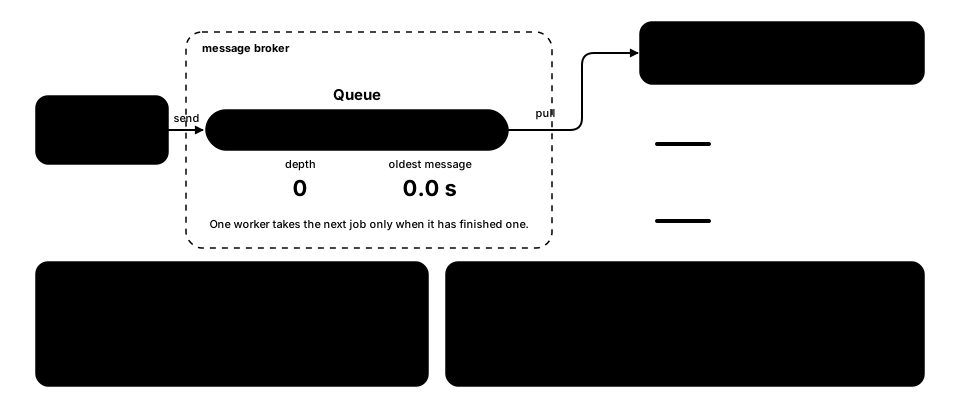
Competing Consumers
worker หลายตัวดึงงานจาก queue เดียวกัน เลยได้แบ่งงานกันทำ และ scale out throughput ได้
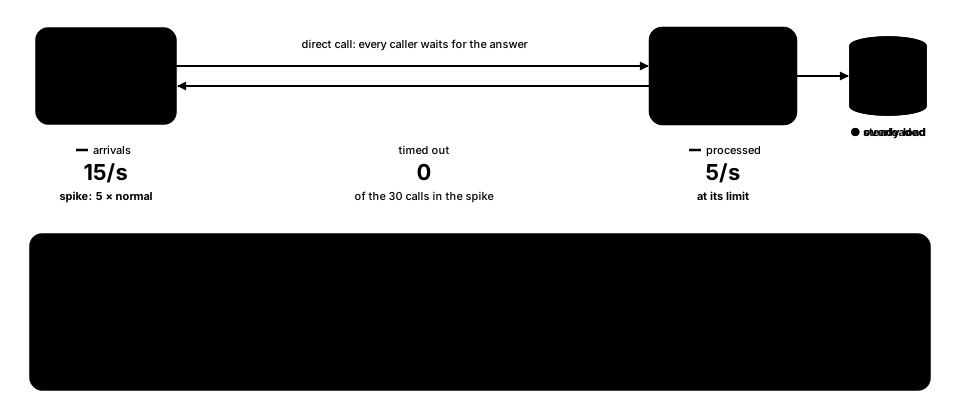
Queue-Based Load Leveling
queue ช่วยรับ traffic spike ไว้ backend จะได้ทำงานในจังหวะที่คงที่
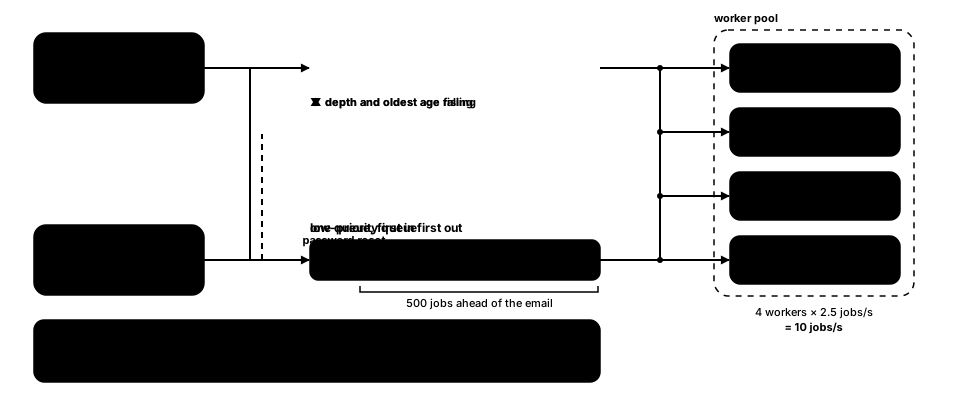
Priority Queue
ประมวลผล message ด่วนก่อน message ทั่วไป
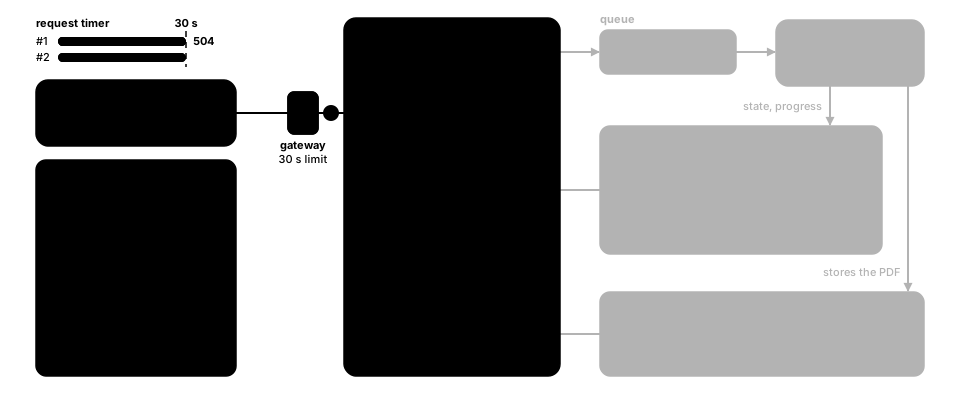
Asynchronous Request-Reply
รับงานไว้ทันทีด้วย 202 แล้วไปทำต่อเบื้องหลัง ให้ client คอย poll status URL
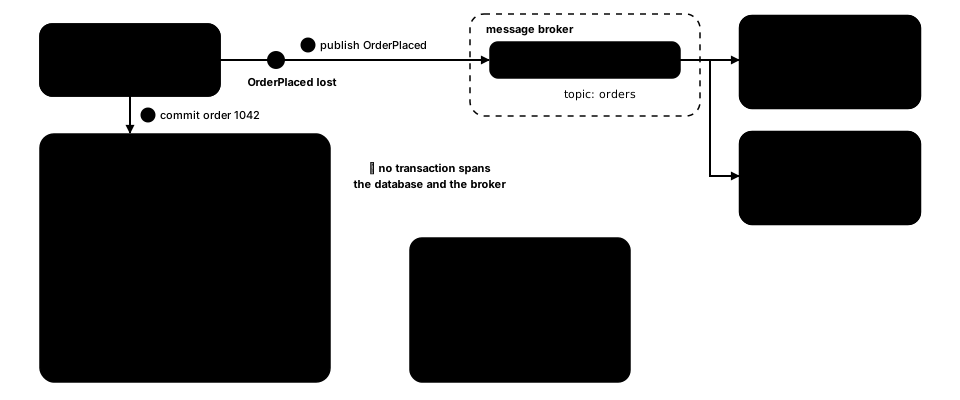
Transactional Outbox
บันทึก event ไว้ใน database transaction เดียวกับข้อมูล แล้วค่อย relay ออกไป: ไม่มีช่องโหว่ของ dual write
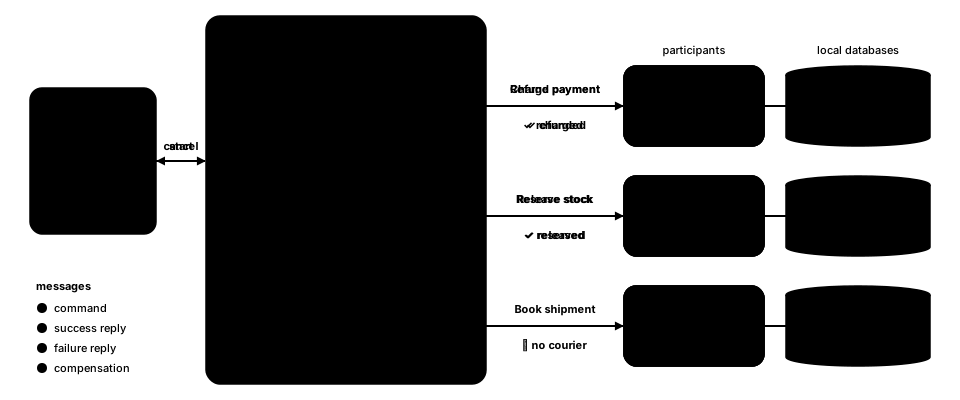
Saga (Orchestration)
coordinator ตัวกลางรัน local transaction ทีละขั้นตามลำดับ และสั่ง compensation ถ้ามีขั้นไหนล้มเหลว
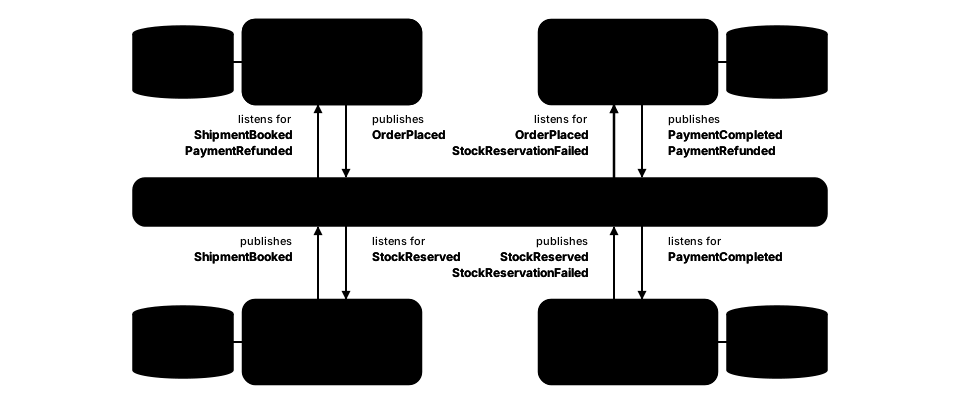
Saga (Choreography)
service ต่าง ๆ ตอบสนองต่อ event ของกันและกันไปจนจบ workflow โดยไม่มี coordinator กลาง
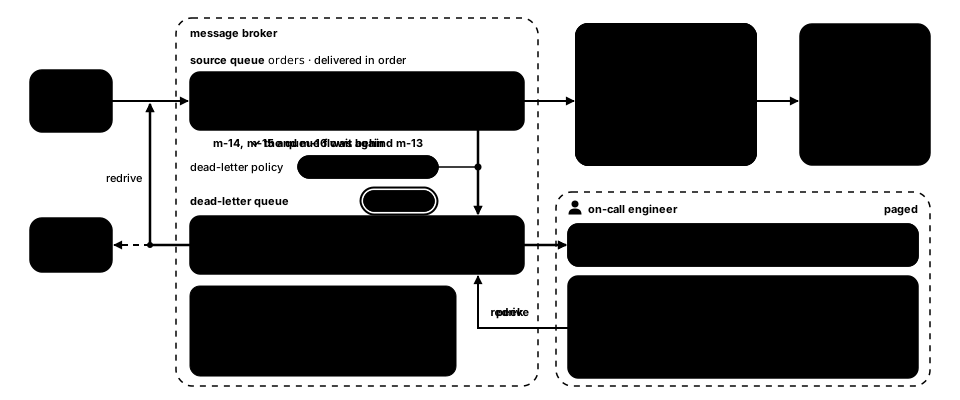
Dead-Letter Queue
พัก message ที่ล้มเหลวซ้ำ ๆ ไว้ต่างหาก จะได้ไม่ขวาง queue และเอามาตรวจดูได้
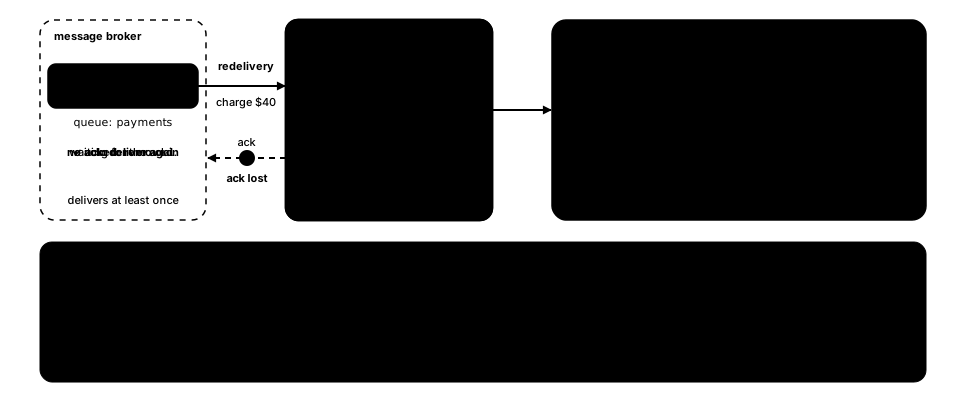
Idempotent Consumer
จำ ID ของ message ที่ประมวลผลไปแล้ว message ที่ส่งซ้ำมาจะได้ไม่มีผลเพิ่ม
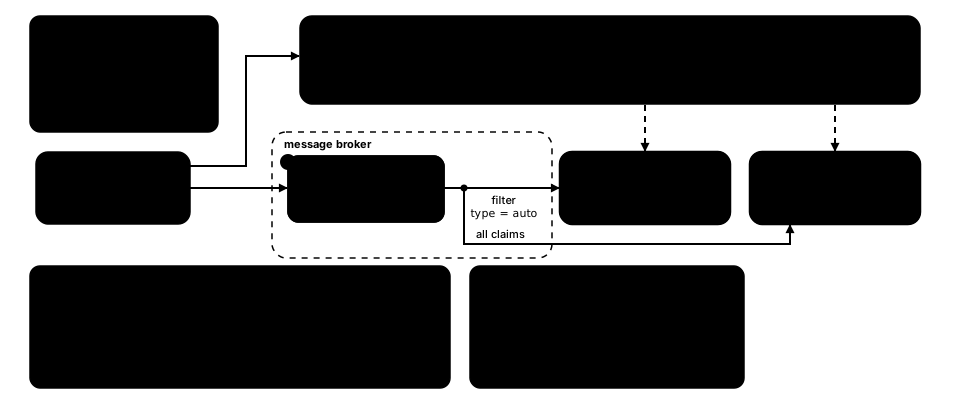
Claim Check
เก็บ payload ใหญ่ ๆ ไว้ใน storage แล้วส่งแค่ reference ผ่าน broker

Pipes and Filters
แบ่งการประมวลผลออกเป็น stage อิสระ แล้วต่อกันด้วย channel
การจัดการข้อมูล
เก็บ ขยาย cache และ sync ข้อมูลข้าม service ยังไง
Cache-Aside
อ่านจาก cache ก่อน ถ้า miss ก็โหลดจาก database แล้วเติมลง cache
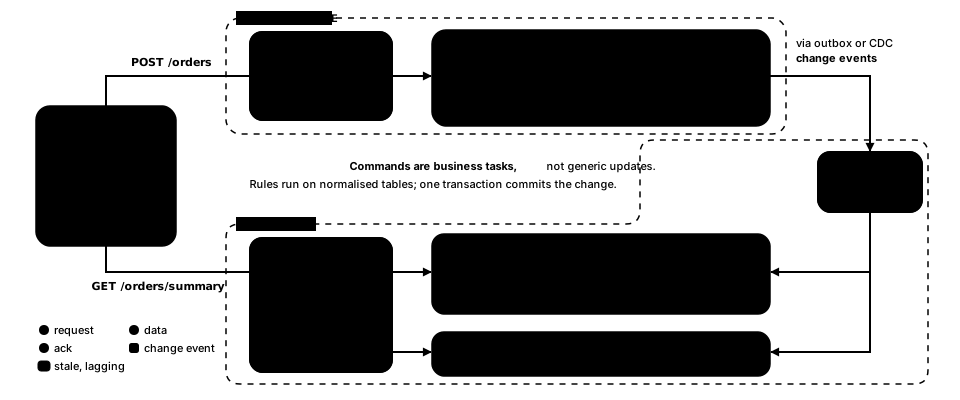
CQRS
แยก write model (command) ออกจาก read model (query) แต่ละฝั่งจะได้ปรับให้เหมาะกับงานของตัวเอง
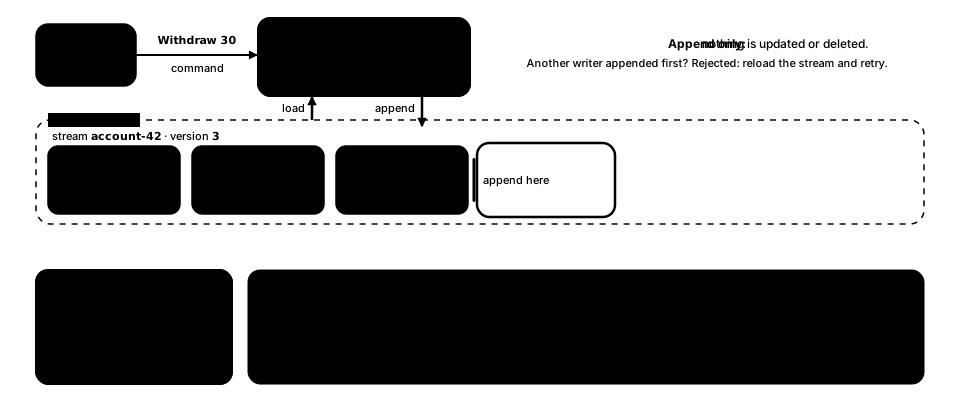
Event Sourcing
เก็บทุกการเปลี่ยนแปลงเป็น event ที่แก้ไม่ได้ แล้วสร้าง state ขึ้นมาใหม่ด้วยการ replay event พวกนั้น
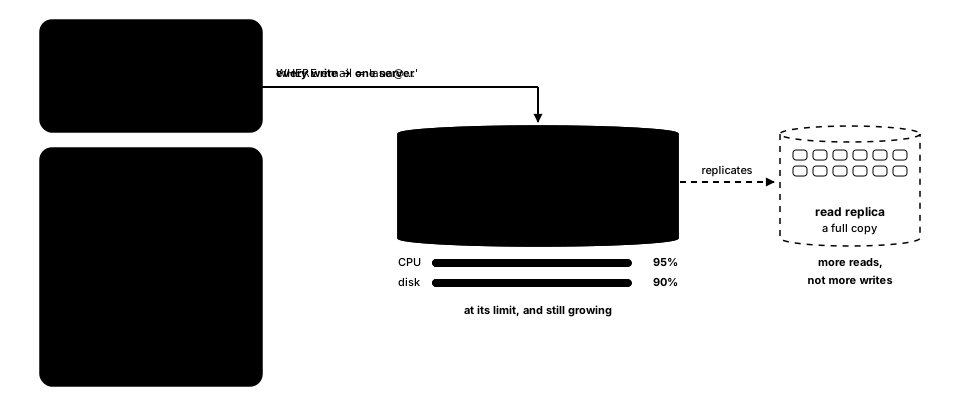
Sharding
แบ่งข้อมูลตามแนวนอนไปไว้หลาย database โดยใช้ shard key
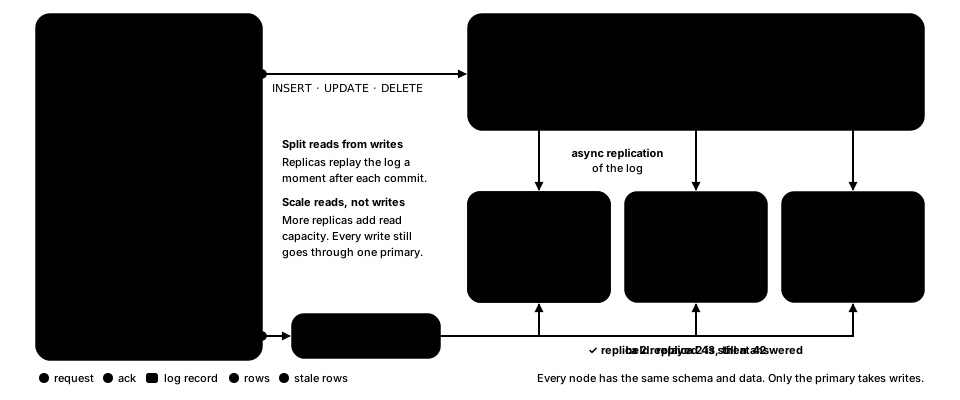
Read Replicas
ส่งการเขียนไปที่ primary แล้วกระจายการอ่านไปที่ replica ที่ update ตามมาแบบ asynchronous
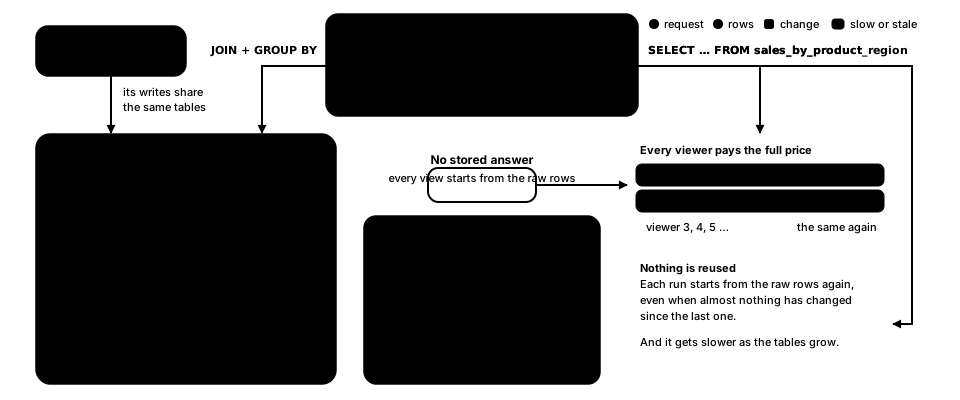
Materialized View
คำนวณ view ที่หน้าตาตรงกับ query ไว้ล่วงหน้า ตอนอ่านจะได้ไม่ต้องเสียค่า join และ aggregation
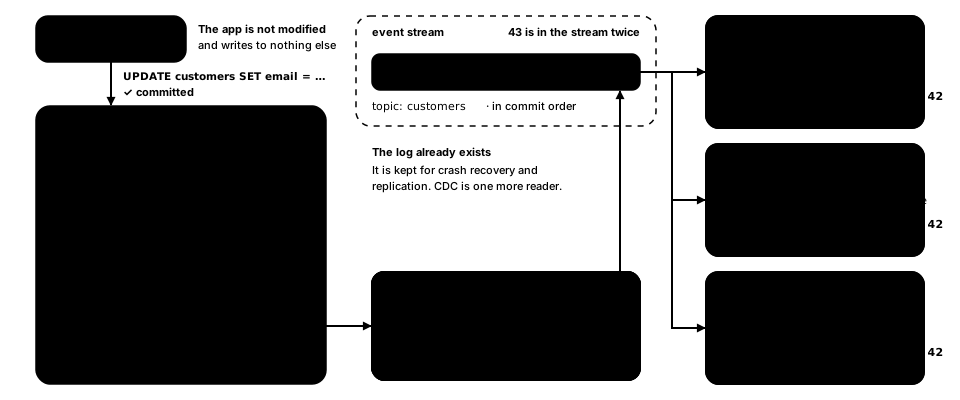
Change Data Capture (CDC)
stream ทุกการเปลี่ยนแปลงที่ commit แล้วจาก log ของ database ไปให้ระบบอื่น
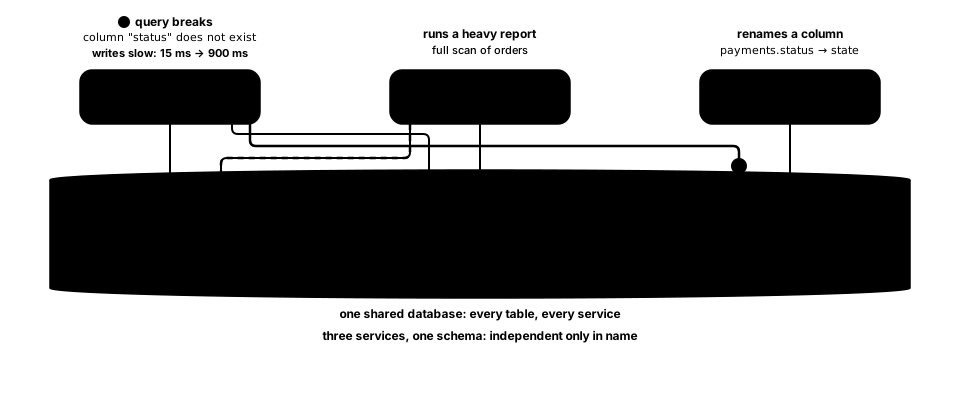
Database per Service
แต่ละ service เป็นเจ้าของข้อมูลของตัวเอง service อื่นต้องผ่าน API หรือ event ของมัน ไม่แตะตารางของมันเลย
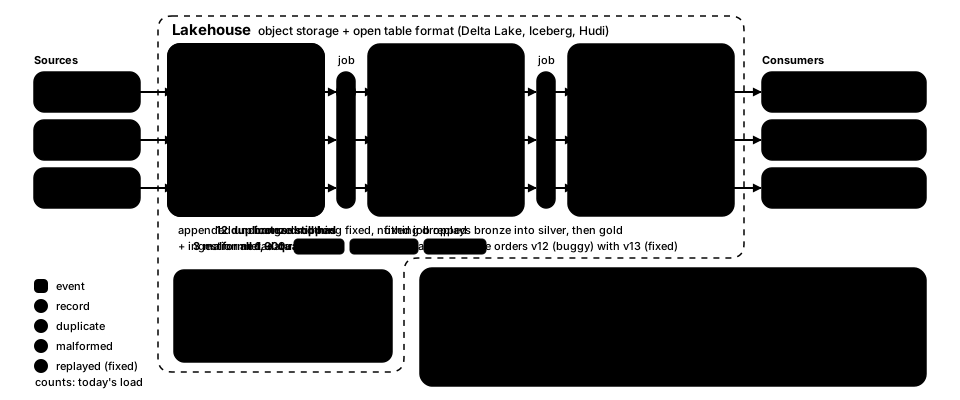
Medallion Architecture
Bronze, silver, gold: ค่อย ๆ ขัดเกลาข้อมูลดิบทีละชั้นใน lakehouse
เจาะลึกฐานข้อมูล
ฐานข้อมูลหาข้อมูล เก็บข้อมูล และกันข้อมูลพังยังไง: index, query plan, transaction และ storage engine พร้อมวิธีใช้ให้เร็วและถูกต้อง
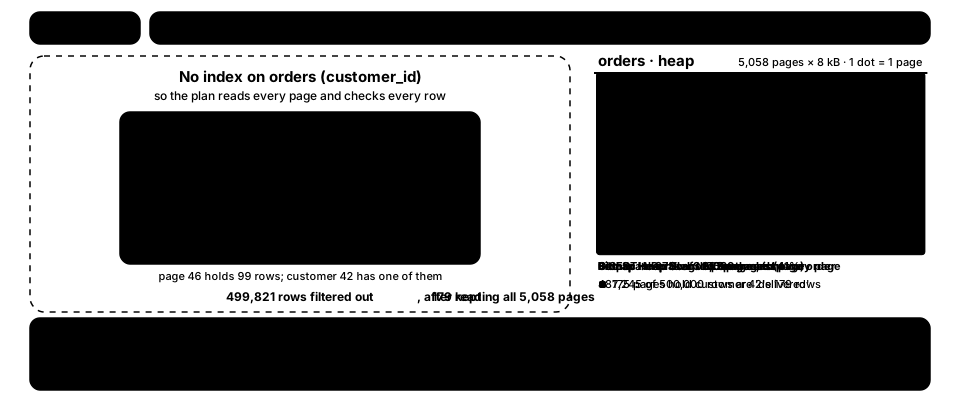
B-Tree Index
B-tree index หา row เจอได้ด้วยการอ่านแค่สามหรือสี่ page ยังไง อ่าน range ออกมาตามลำดับได้ยังไง และทุก insert ต้องจ่ายเท่าไรเพื่อให้มันเรียงอยู่เสมอ
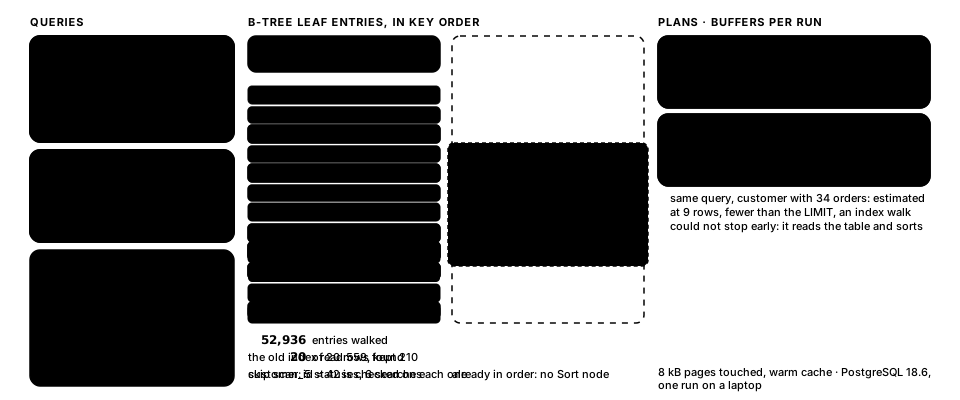
Composite Index
index หลาย column ใช้ได้กับ query ที่ใช้ leading column ของมัน: เอา column ที่เทียบด้วย equality ไว้ก่อน แล้วเอา column ที่ใช้ range หรือ sort ไว้ท้ายสุด
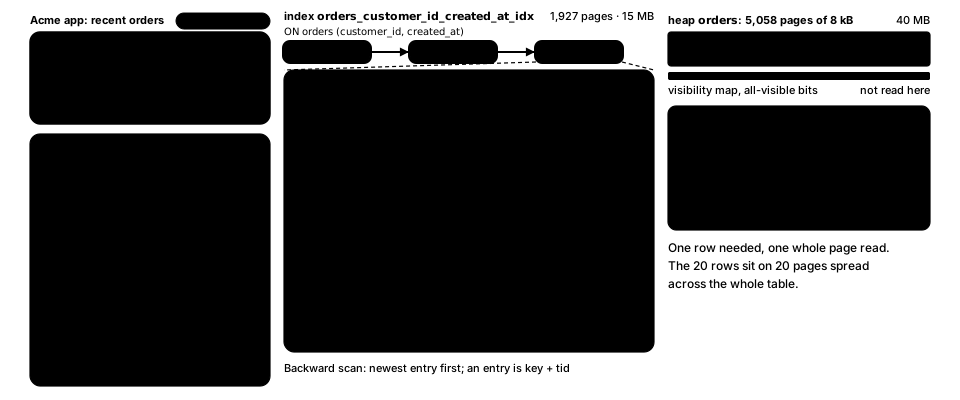
Covering Index
ตอบ query จาก index อย่างเดียว: ใส่ column ที่ query select ไว้ใน index ด้วย จะได้ไม่ต้องอ่าน table เลย และ scan ก็เป็นแบบ index-only
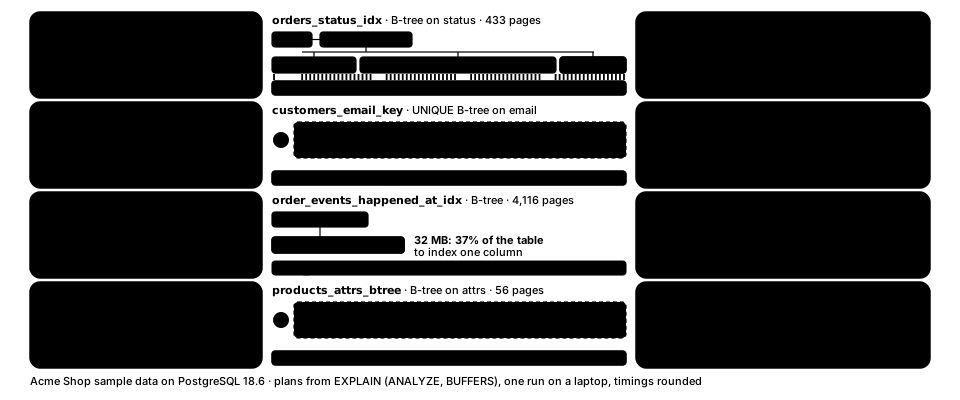
Index Types
ไปไกลกว่า B-tree: hash, GIN สำหรับ array, JSON และ text, GiST, BRIN สำหรับข้อมูลที่เรียงตามเวลา รวมถึง partial index และ expression index
Query Execution Plans
อ่าน EXPLAIN แบบที่ planner คิด: scan, join, จำนวน row ที่ประมาณไว้เทียบกับของจริง และ statistics ที่อยู่เบื้องหลังแต่ละการตัดสินใจ
Join Algorithms
Nested loop, hash join และ merge join: แต่ละแบบ join สอง table ยังไง มีต้นทุนเท่าไหร่ และ planner เลือกใช้ตอนไหน
N+1 Queries
query หนึ่งตัวดึง list แล้วอีกหนึ่งตัวต่อทุกแถว: ORM ตกหลุมนี้ได้ยังไง จับได้ยังไง และ batching หรือ join แก้มันได้ยังไง
Keyset Pagination
แบ่งหน้าด้วย WHERE key > key สุดท้ายที่เห็น แทน OFFSET ทำให้หน้า 1,000 เร็วเท่าหน้า 1 และไม่มีแถวไหนซ้ำหรือหายไป
Normalization & Denormalization
เก็บข้อมูลแต่ละอย่างไว้ที่เดียวเพื่อให้ข้อมูลไม่ขัดกัน แล้วค่อยตั้งใจ copy บางส่วนไว้ตรงที่ต้องอ่านเร็ว และคอยดูแลให้ copy ตรงกับต้นฉบับ
Transaction Isolation Levels
transaction ที่รันพร้อมกันเห็นงานของกันและกันได้แค่ไหน: anomaly ที่แต่ละ isolation level ยอมให้เกิด และค่า default ที่แต่ละ engine ใช้
MVCC
Multi-version concurrency control: update จะเขียน row version ใหม่ ส่วน reader เห็น snapshot และ vacuum ลบ version ที่ตายแล้วทิ้ง
Locks & Deadlocks
row lock ทำให้ writer ต้องรอกันเอง ถ้าสอง transaction รอกันและกันก็คือ deadlock แล้ว database จะ abort ตัวหนึ่งทิ้ง
Optimistic Concurrency Control
update row ก็ต่อเมื่อมันยังไม่ถูกเปลี่ยนตั้งแต่ตอนที่เราอ่าน โดยใช้ version column แล้ว retry เมื่อชนกัน แทนการถือ lock ไว้
Write-Ahead Log
เขียนทุกการเปลี่ยนลง log ก่อนนำไปใช้จริง ทำให้ commit รอดจาก crash ได้ การ recover ก็แค่ replay log และ replica กับ backup ก็ตาม log นี้ไป
LSM Tree vs B-Tree
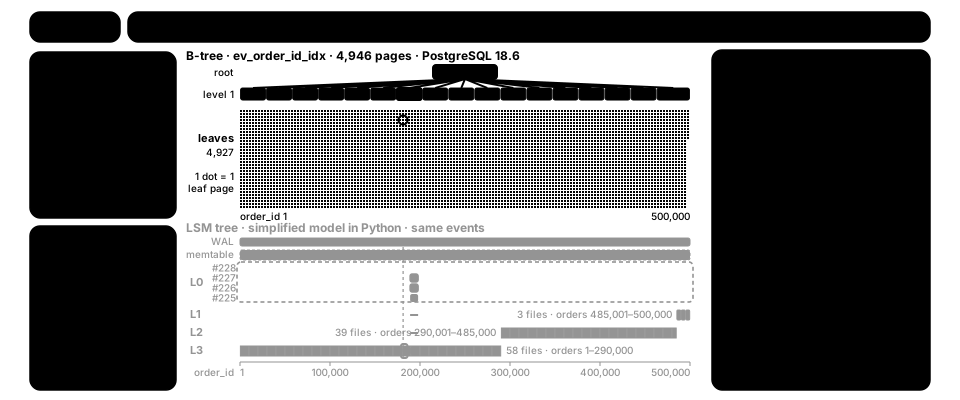
storage engine สองแบบ: update page ที่เดิม หรือต่อท้ายไว้ใน memory แล้ว merge file ที่เรียงแล้ว และแต่ละแบบต้องจ่ายเท่าไรตอนอ่านและตอนเขียน
Row vs Column Storage
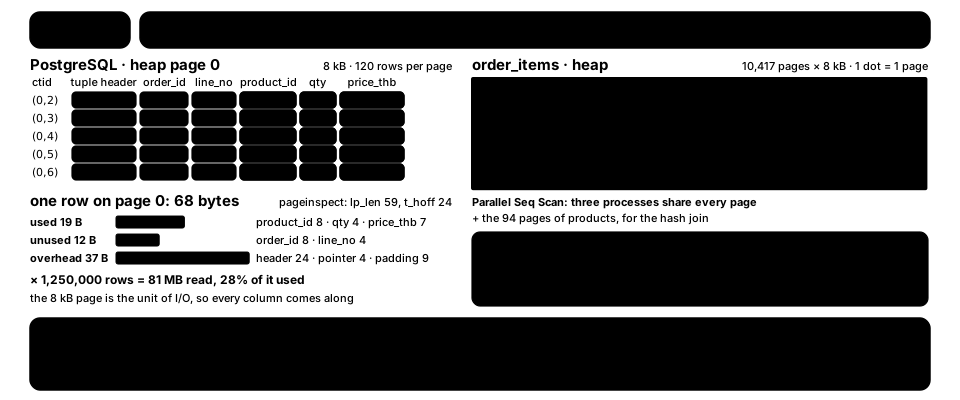
เก็บค่าของ row เดียวกันไว้ติดกันสำหรับงาน transaction หรือเก็บค่าของ column เดียวกันไว้ติดกันสำหรับงาน analytics และทำไม column store ถึง scan และบีบอัดได้เร็วกว่ากันมาก
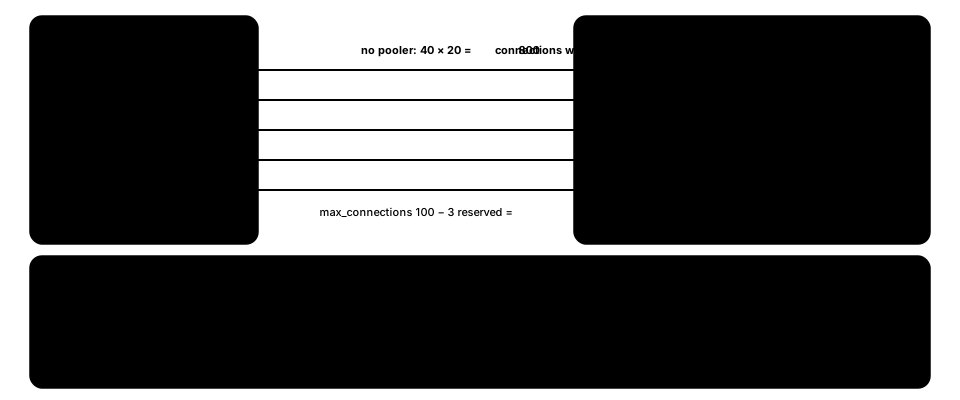
Connection Pooling
ให้ request จำนวนมากใช้ database connection ไม่กี่ตัวร่วมกัน ทำให้การตั้ง connection และ memory ต่อ connection ไม่เป็นตัวจำกัด database อีกต่อไป
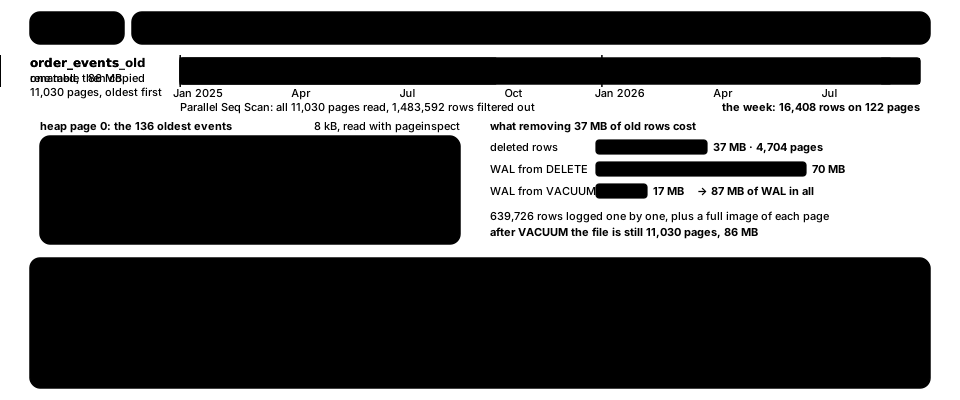
Table Partitioning
แบ่ง table ใหญ่ออกเป็น partition ตาม range, list หรือ hash ทำให้ query ข้าม partition ได้ และลบข้อมูลเก่าทิ้งได้ในพริบตา
ความทนทานและความน่าเชื่อถือ
ให้ระบบยังทำงานต่อได้ แม้ของที่ต้องพึ่งจะช้า รับโหลดไม่ไหว หรือล่มไปแล้ว
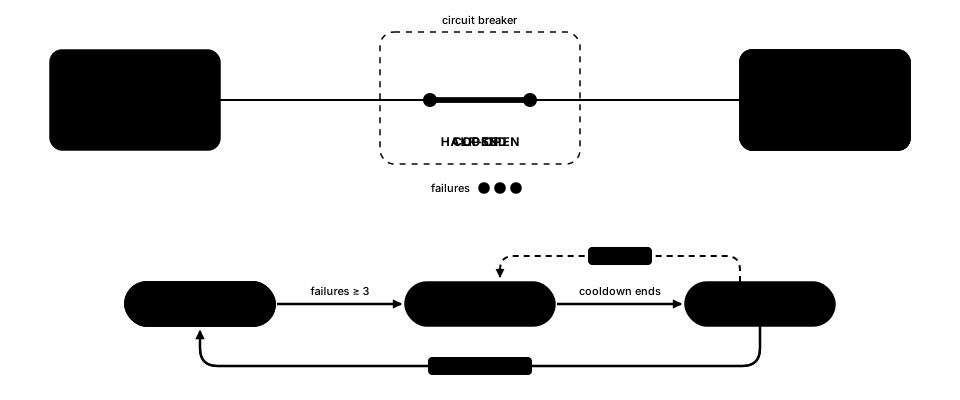
Circuit Breaker
เลิกเรียก dependency ที่กำลังพัง ให้ fail fast แล้วใช้ fallback แทน จากนั้นคอยลองเรียกดูจนกว่ามันจะกลับมาปกติ
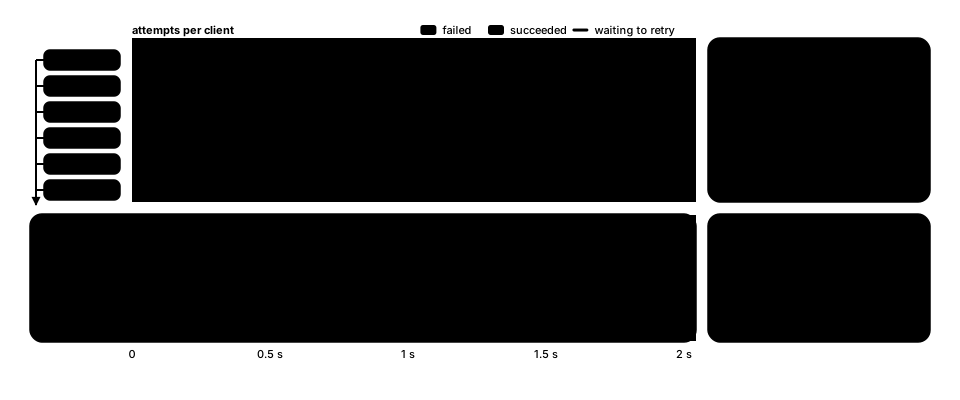
Retry with Backoff & Jitter
Retry error ที่เกิดแค่ชั่วคราว โดยรอนานขึ้นเรื่อย ๆ และสุ่มระยะรอ client จะได้ไม่แห่กันกลับมาถล่มพร้อมกัน
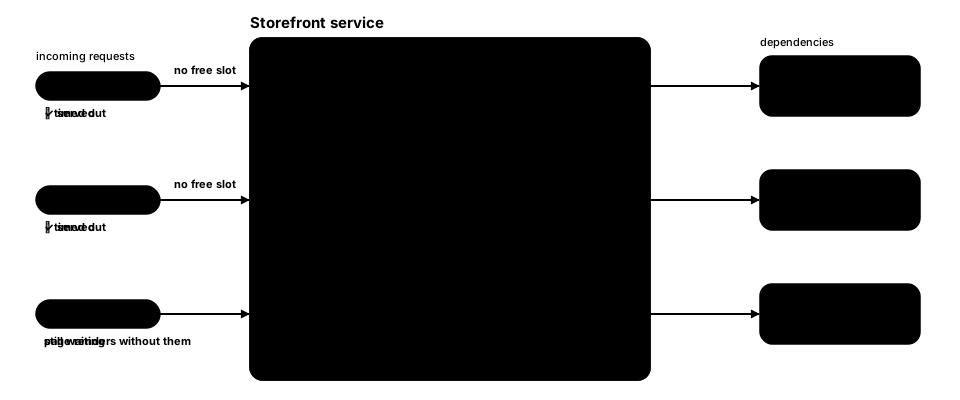
Bulkhead
ให้แต่ละ dependency มี pool ทรัพยากรของตัวเอง พังที่เดียวจะได้ไม่ทำเรือจมทั้งลำ
Timeout & Fallback
ตั้งเวลาสูงสุดให้ทุก remote call แล้วพอหมดเวลาก็ลดระดับการทำงานลงอย่างนุ่มนวล
Rate Limiting & Throttling
จำกัดว่าแต่ละ client เรียกได้ถี่แค่ไหน (token bucket) ส่วนที่เกินก็ตัดทิ้งด้วย 429
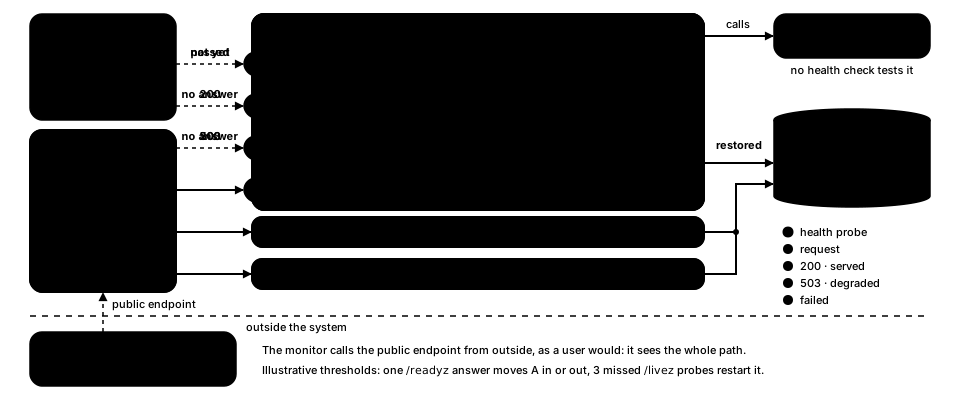
Health Endpoint Monitoring
เปิด liveness check กับ readiness check ไว้ให้ load balancer และระบบ monitor คอย probe
Leader Election
Instance ต่าง ๆ เลือก coordinator ขึ้นมาตัวเดียว พอ lease ของมันหมดอายุ ตัวอื่นก็ขึ้นมาแทน
Compensating Transaction
ย้อนขั้นที่ทำเสร็จไปแล้ว ตอนที่งานหลายขั้นพังกลางทาง
Chaos Engineering
ตั้งใจใส่ failure เข้าไปในระบบ เพื่อพิสูจน์ว่ามันลดระดับการทำงานลงอย่างที่คาดไว้
การ Deploy และ Release
ปล่อยของใหม่อย่างปลอดภัย คอยดูใน production และ rollback ได้ไว
Blue-Green Deployment
รันเวอร์ชันใหม่ไว้ข้าง ๆ เวอร์ชันเก่า แล้วสลับ traffic ทั้งหมดไปทีเดียว
Canary Release
แบ่ง traffic ส่วนเล็ก ๆ ไปที่เวอร์ชันใหม่ คอยดู metric ของมัน แล้วค่อยเพิ่มสัดส่วนหรือ rollback
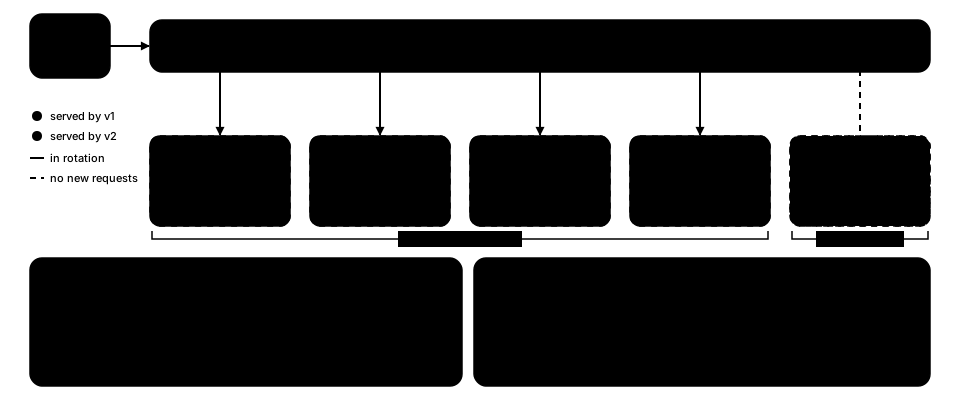
Rolling Update
เปลี่ยน instance ทีละชุด โดยที่ service ยังทำงานอยู่ตลอด
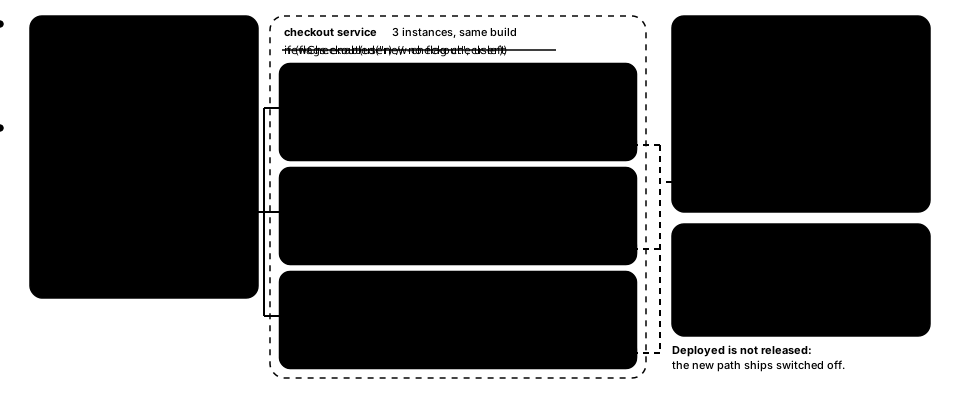
Feature Flags
Deploy โค้ดไว้แบบ dark ก่อน แล้วค่อยเปิด feature ตามผู้ใช้หรือตามเปอร์เซ็นต์ได้ตอน runtime
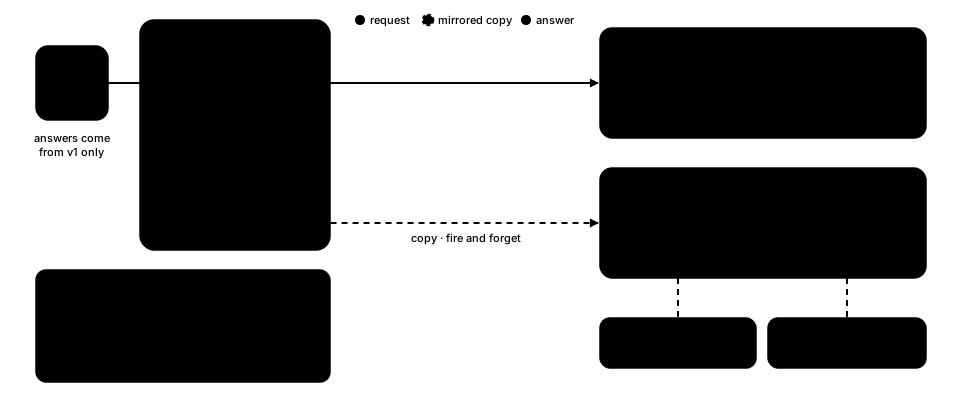
Shadow Traffic
Mirror request จริงไปที่เวอร์ชันใหม่ แล้วเทียบผลกันโดยไม่กระทบผู้ใช้
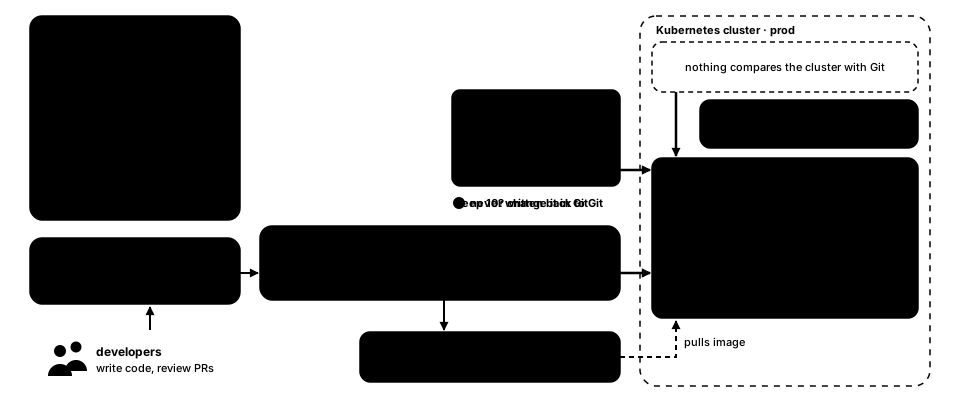
GitOps
Git เก็บ desired state ไว้ แล้วมี agent คอย reconcile cluster ให้ตรงกับ Git อยู่ตลอด
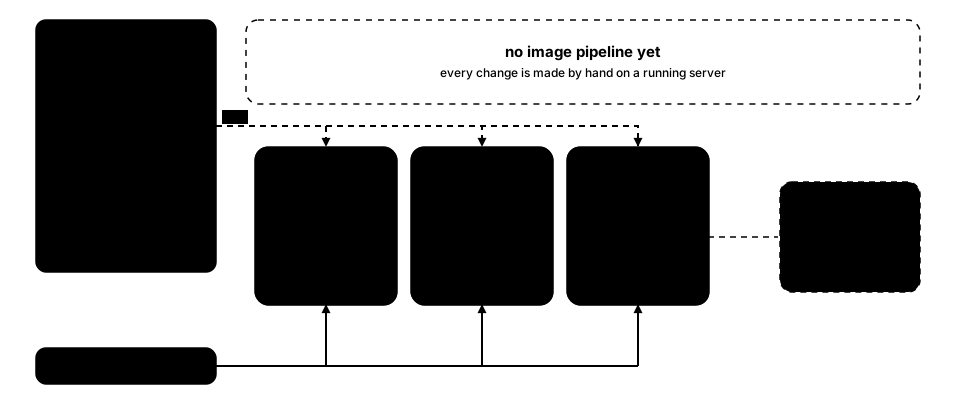
Immutable Infrastructure
ไม่ patch server บนเครื่องเดิมเลย: bake image ใหม่ แล้วเอาเครื่องใหม่มาแทน
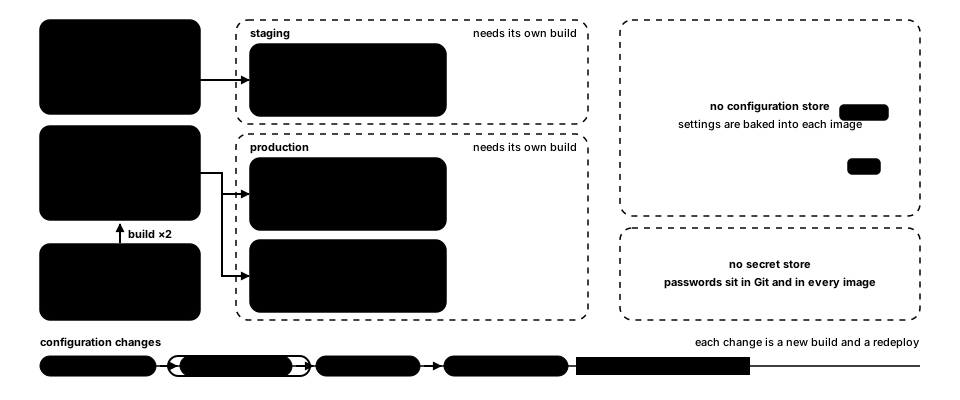
External Configuration Store
เก็บ configuration ไว้นอก deployment package ใน store กลางที่แอปอ่านตอน runtime
การย้ายระบบและปรับให้ทันสมัย
ค่อย ๆ ปรับระบบเก่าไปทีละขั้น ไม่ต้องรื้อเขียนใหม่หมดในทีเดียว
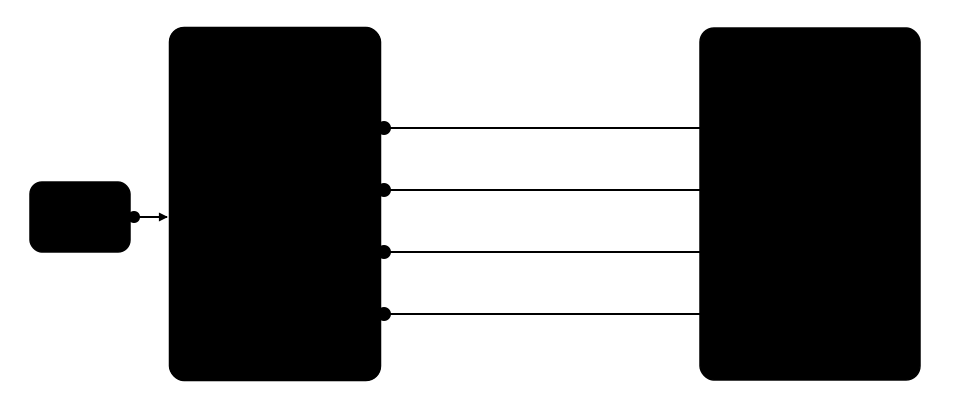
Strangler Fig
วาง facade ไว้หน้าระบบ legacy แล้วย้าย route ไปที่ service ใหม่ทีละอัน
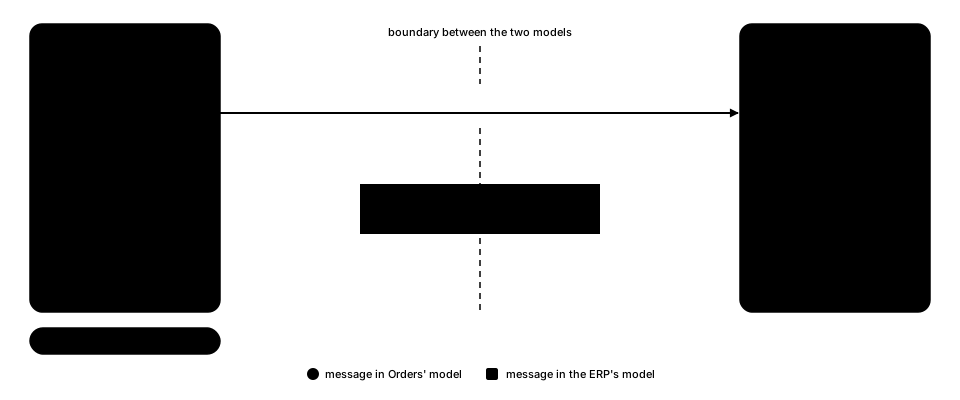
Anti-Corruption Layer
Layer ที่คอยแปล กันไม่ให้ model ของระบบ legacy รั่วเข้ามาใน domain ใหม่
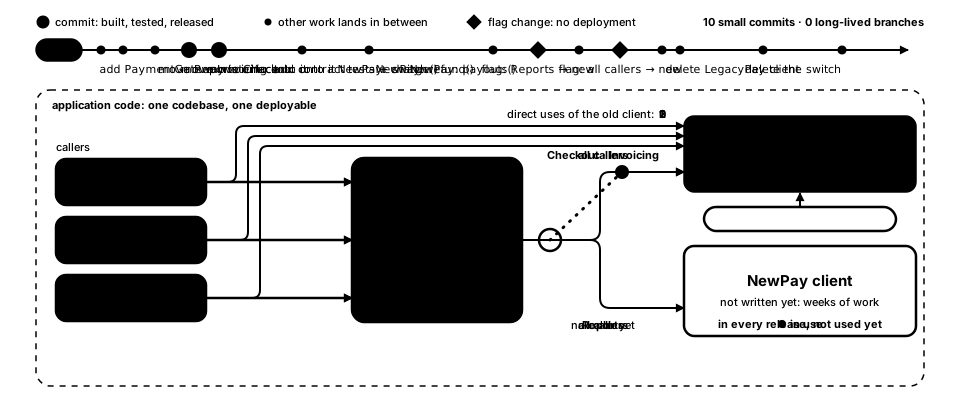
Branch by Abstraction
ใส่ abstraction เข้าไป สร้าง implementation ใหม่ไว้ข้างหลัง แล้วค่อยสลับไปใช้
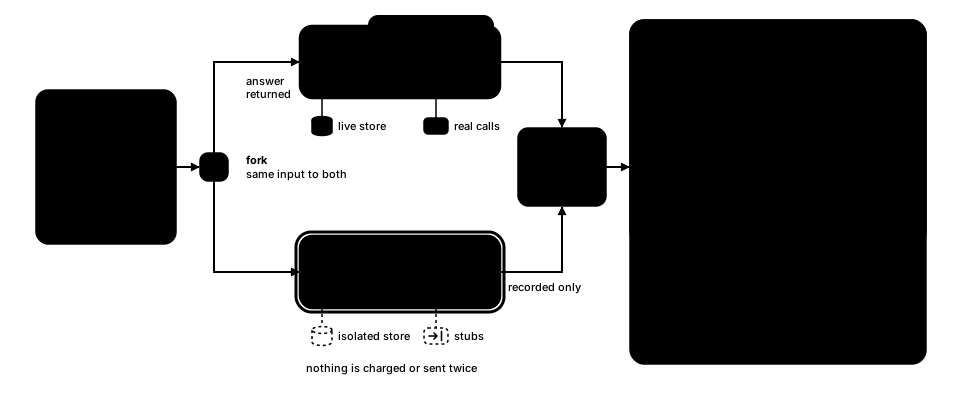
Parallel Run
รันของเก่ากับของใหม่คู่กันด้วย input เดียวกัน แล้วเทียบผลก่อนสลับไปใช้ของใหม่
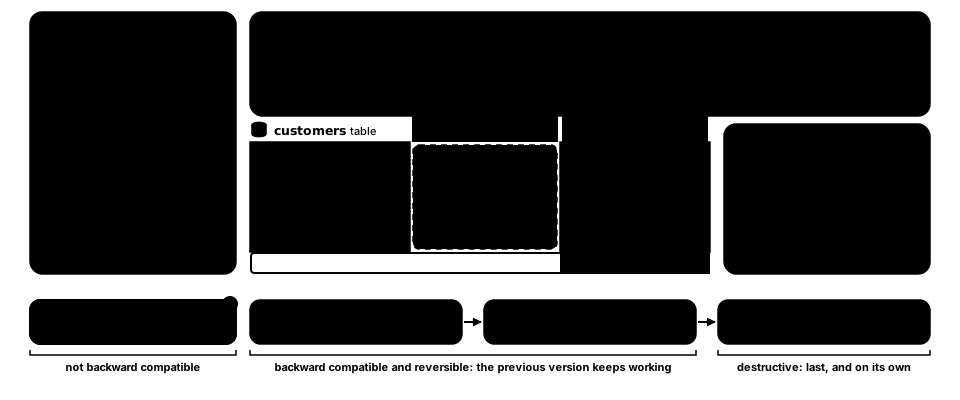
Expand and Contract
เปลี่ยน schema หรือ API ทีละขั้นแบบ backward-compatible: expand, migrate แล้วค่อย contract
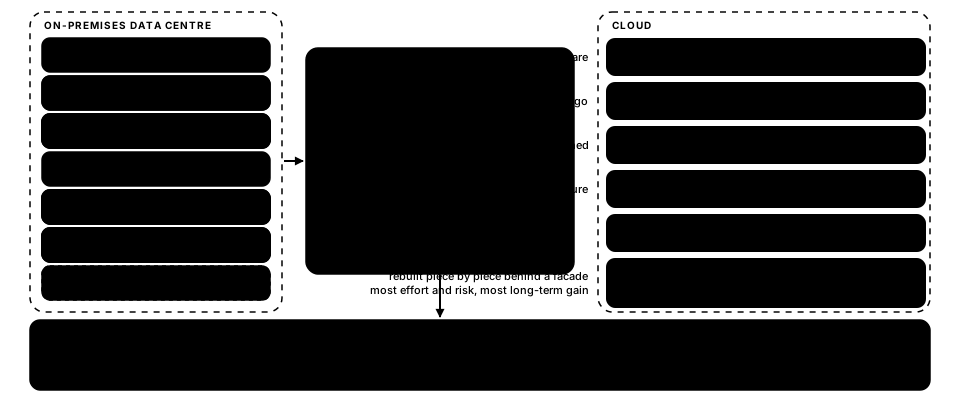
Cloud Migration Strategies (7 Rs)
Rehost, replatform, refactor, repurchase, relocate, retain หรือ retire: แต่ละ workload เลือกมาแบบเดียว
AWS Cloud Adoption Framework (CAF)
หก perspective กับ foundational capability ของแต่ละตัว ที่บอกว่าองค์กรต้องสร้างอะไรบ้างนอกเหนือจากเทคโนโลยี ถึงจะขึ้น cloud ได้จริง
AWS Migration Process
Assess, mobilize แล้วค่อย migrate and modernize: business case, landing zone และ migration wave ที่ย้าย portfolio ทั้งชุดขึ้น AWS
Observability และการดูแลระบบ
รู้ว่าระบบกำลังทำอะไรอยู่ และพอมีปัญหาก็รู้ว่าเพราะอะไร
Distributed Tracing
ส่ง trace context ต่อกันไปทุก service แล้วเอา span ทั้งหมดมาต่อเป็น timeline เดียว
Centralized Logging
ส่ง structured log จากทุก service ไปรวมไว้ใน store เดียวที่ค้นได้ แล้วโยงกันด้วย request ID
SLOs & Error Budgets
วัด SLI เทียบกับเป้าหมาย แล้ว alert ตาม burn rate ของ error budget ไม่ใช่ alert ทุกครั้งที่ระบบสะดุดนิดเดียว
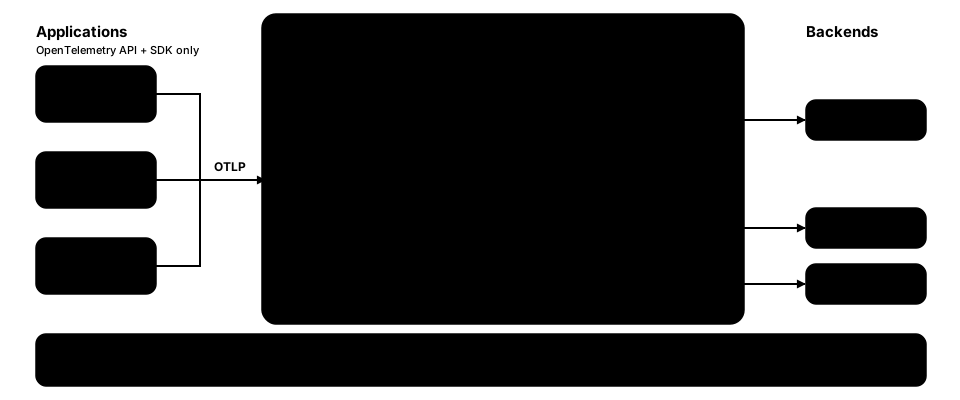
Telemetry Pipeline (OpenTelemetry)
รับ ประมวลผล และ export trace, metric และ log ผ่าน collector ตัวเดียวที่ไม่ผูกกับ vendor เจ้าไหน
หลักการ DevOps และ SRE
ทีมจะส่งของได้ถี่และให้ production เสถียรไปพร้อมกันได้ยังไง: หลักคิด ตัวเลขที่ใช้วัด และวิธีทำงานเบื้องหลัง DevOps กับ SRE
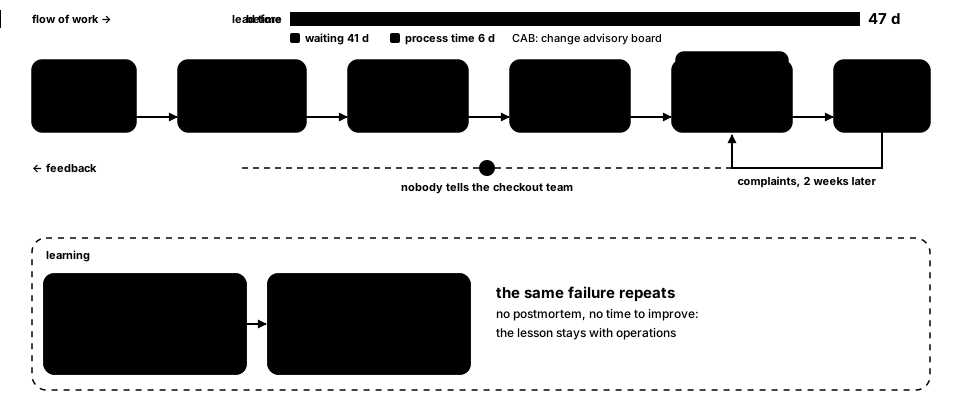
The Three Ways
DevOps ในสามหลักการ: เร่ง flow ของงานให้ไปถึงลูกค้า ขยาย feedback ให้ย้อนกลับมาถึงทีม และเรียนรู้ต่อไปไม่หยุด
DORA Metrics
วัด software delivery ด้วย throughput และความเสถียร: change ไปถึง production บ่อยแค่ไหนและเร็วแค่ไหน แล้วพังบ่อยแค่ไหน
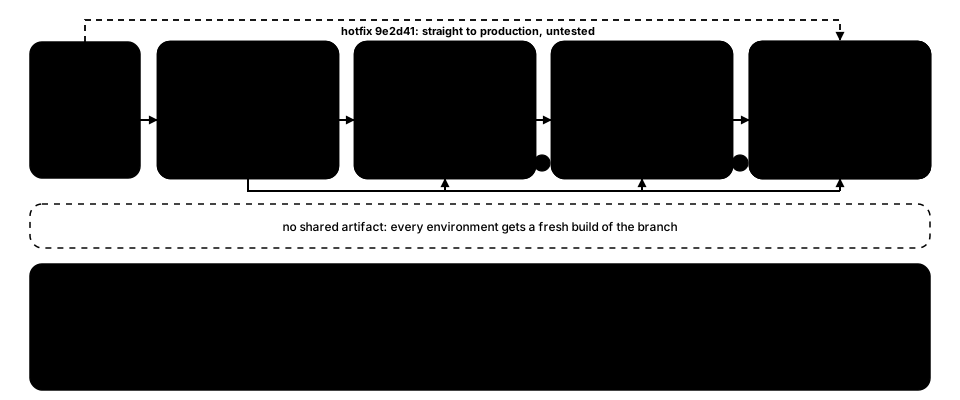
Continuous Delivery
ทำให้ทุก change พร้อม release เสมอ: deployment pipeline จะ build ครั้งเดียว test ทีละ stage แล้ว promote artifact ตัวเดิมไปถึง production
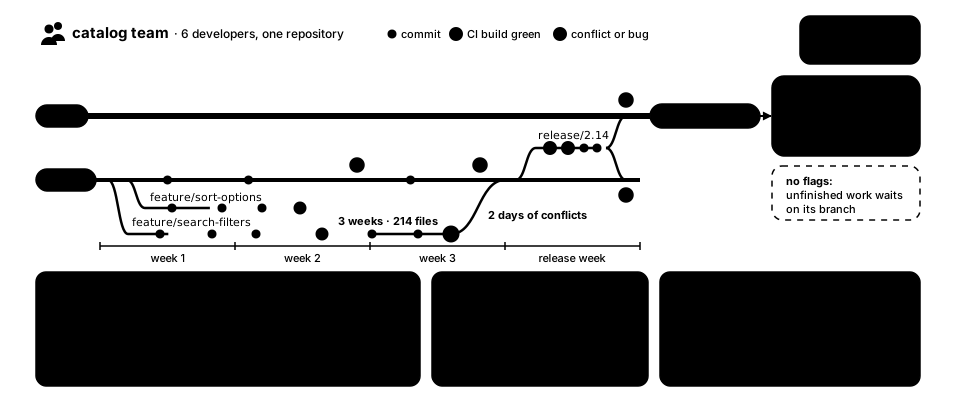
Trunk-Based Development
ทุกคน merge การเปลี่ยนแปลงเล็ก ๆ เข้า main branch เดียวกันอย่างน้อยวันละครั้ง แล้วใช้ feature flag ซ่อนงานที่ยังไม่เสร็จแทนการแยก branch ยาว ๆ
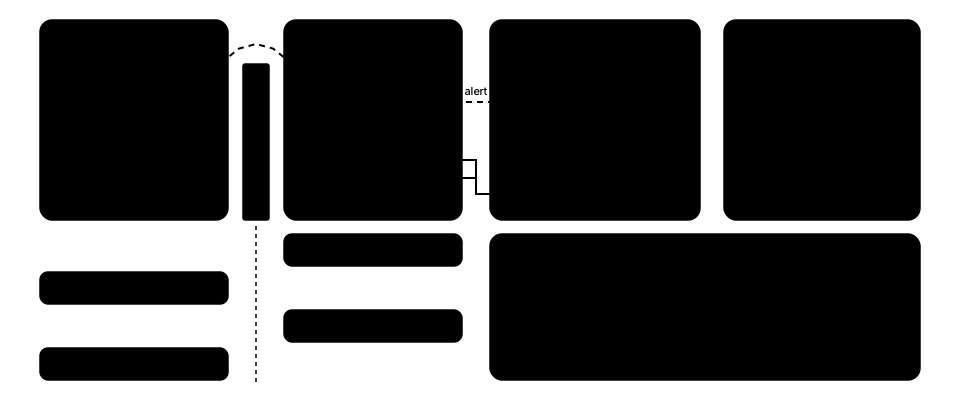
You Build It, You Run It
ทีมที่สร้าง service คือทีมที่ดูแลมันใน production และอยู่ on-call เอง ทำให้คนที่แก้ปัญหาได้รู้เรื่องก่อนใคร
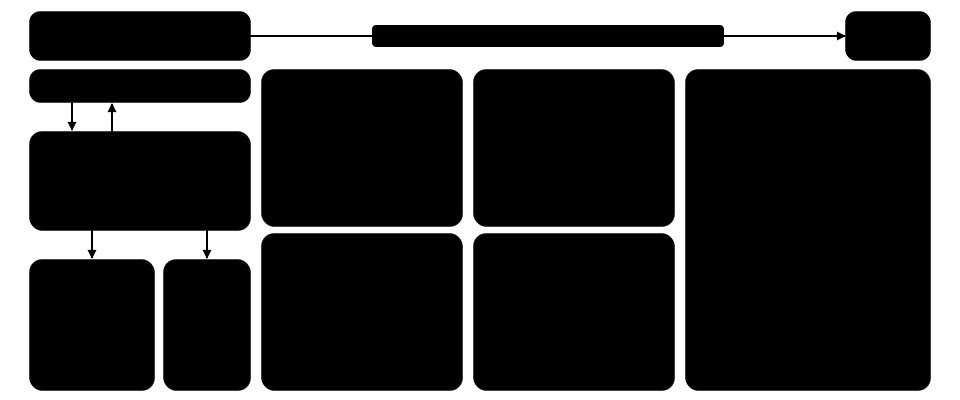
Golden Signals, RED & USE
ควรวัดและ alert อะไร: latency, traffic, errors และ saturation ส่วน RED ใช้กับ service ที่ขับด้วย request และ USE ใช้กับ resource
Eliminating Toil
หางาน operation ที่ต้องทำมือซ้ำ ๆ และโตตามระบบ แล้ววัดมัน ตั้งเพดานให้มัน และทำ automation กำจัดมันทิ้ง
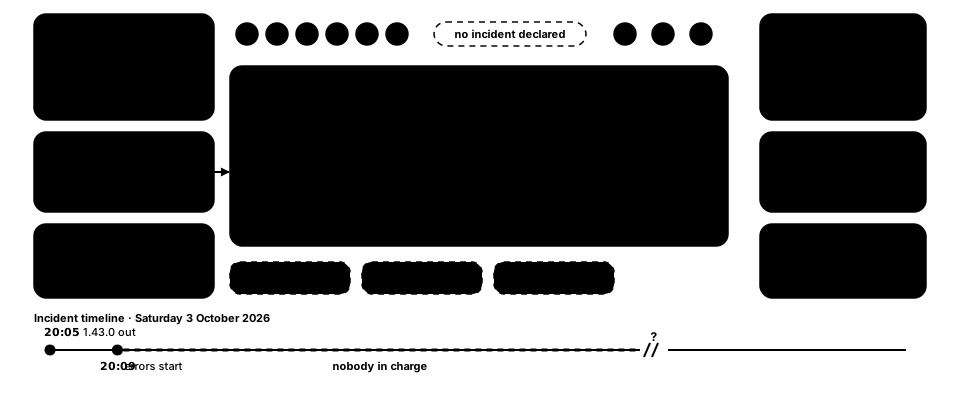
Incident Management
วิธีรับมือที่ซ้อมไว้แล้วสำหรับตอน production พัง: ประกาศ incident ให้เร็ว แบ่งบทบาท mitigate ก่อน และให้ทุกคนรู้ความคืบหน้าตลอด

Blameless Postmortems
เรียนรู้จากทุก incident โดยไม่โทษใคร: มี timeline, contributing factor และ action item ที่ติดตามได้ แล้วแชร์ให้คนเห็นกันกว้าง ๆ
SPACE & DevEx
วัด developer productivity โดยไม่นับโค้ด: ใช้ survey กับข้อมูลจากระบบดูเรื่อง satisfaction, flow, feedback loop และ cognitive load
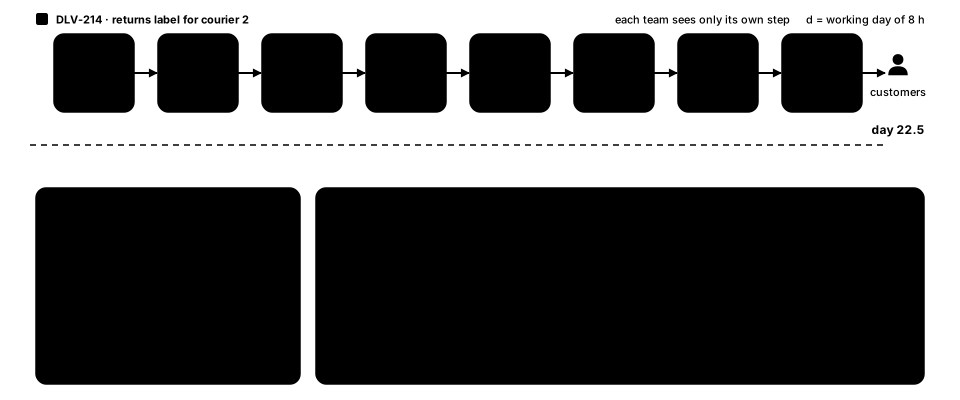
Value Stream Mapping
วาดว่า change หนึ่งเดินทางจากไอเดียไปถึงลูกค้ายังไง เทียบเวลาที่ใช้ทำงานกับเวลาที่รอ แล้วกำจัดการรอที่ใหญ่ที่สุด
CALMS
มุมมองสำหรับประเมินการนำ DevOps มาใช้: culture, automation, lean, measurement และ sharing รวมถึง dimension ที่ฉุดตัวอื่นไว้
Testing Pyramid
มี unit test ที่เร็วจำนวนมาก, integration test กับ contract test น้อยลงมา และ end-to-end test แค่ไม่กี่ตัว: feedback เลยยังเร็ว และ test ที่ fail ก็ชี้ไปที่ต้นเหตุ
ITIL 4
IT service management ด้วย ITIL 4: service value system, guiding principles และ change enablement ที่ทำงานไปด้วยกันกับ DevOps ไม่ใช่สวนทางกัน
Platform Engineering
หลักการออกแบบ platform ภายในองค์กรและ framework ที่ควรยึด: สร้างยังไง จัดทีมรอบมันยังไง และทำให้ปลอดภัย ออกแบบดี และคุมค่าใช้จ่ายได้ยังไง
The Twelve-Factor App
กฎสิบสองข้อสำหรับ app ที่ deploy ได้เรียบร้อยทุกที่: เก็บ config ไว้ใน environment, ใช้ process แบบ stateless และแยก build, release กับ run ออกจากกัน
Infrastructure as Code
เขียน infrastructure เป็นโค้ดที่อยู่ใน version control: review plan แล้ว apply แบบเดียวกันในทุก environment และจับ drift ได้
Team Topologies
ทีมสี่ประเภทกับ interaction mode สามแบบ ที่จัดทีมให้ตรงกับ flow ของการเปลี่ยนแปลง และคุม cognitive load ไม่ให้ล้น
Platform as a Product
internal developer platform ที่ดูแลแบบ product: developer คือลูกค้าของมัน ส่วน self-service คือ interface และ adoption ต้องได้มาจากการที่ทีมเลือกใช้เอง
Golden Paths
เส้นทางที่ปูไว้และมีคนดูแล สำหรับงานที่ทำบ่อย: template ตัวเดียวสร้าง service พร้อม pipeline, infrastructure และ monitoring ของมัน
Well-Architected Framework
เอา workload มา review เทียบกับหก pillar ตั้งแต่ operational excellence ไปจนถึง sustainability แล้วตัดสินใจเรื่อง trade-off ระหว่าง pillar เหล่านั้น
FinOps
ให้ cloud cost เป็นความรับผิดชอบร่วมกัน: แบ่งค่าใช้จ่ายไปให้ทีมที่ทำให้เกิดมัน แล้ว optimize ค่าใช้จ่ายนั้น และติดตามต้นทุนต่อหนึ่งหน่วยของ value
Supply Chain Security (SLSA)
พิสูจน์ว่าของที่ deploy ถูก build มาจาก source ของเราจริง: มี build provenance, SBOM, signature และการตรวจก่อน deploy ทุกครั้ง
Policy as Code
เขียนกฎเป็นโค้ดแล้วตรวจอัตโนมัติทั้งใน CI และตอน deploy เพื่อให้ guardrail มาแทนด่าน approve ด้วยมือ
อัลกอริทึมและโครงสร้างข้อมูล
พื้นฐานที่ควรรู้: โค้ดค้นหา เรียงลำดับ เรียกตัวเอง และเดินกราฟยังไง แล้วแต่ละแบบเปลืองแค่ไหนเมื่อข้อมูลโตขึ้น
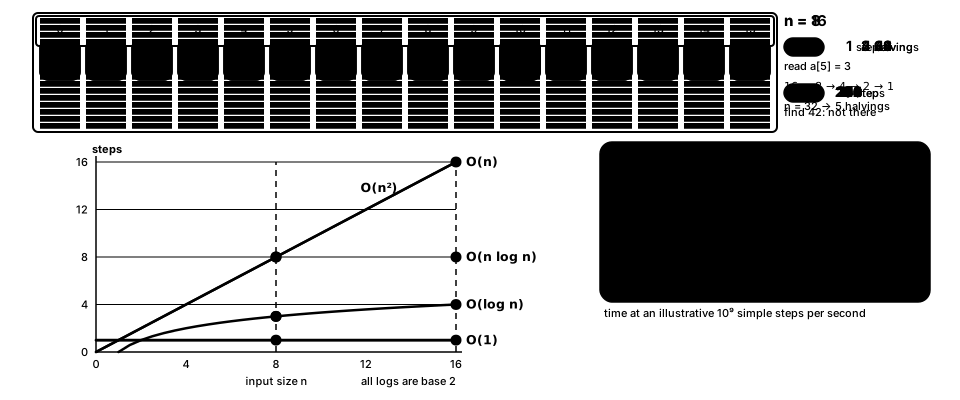
Big-O Notation
ต้นทุนของอัลกอริทึมโตตาม input ยังไง: วาง O(1), O(log n), O(n), O(n log n) และ O(n²) เทียบกันให้เห็นตอนที่ n โตขึ้น
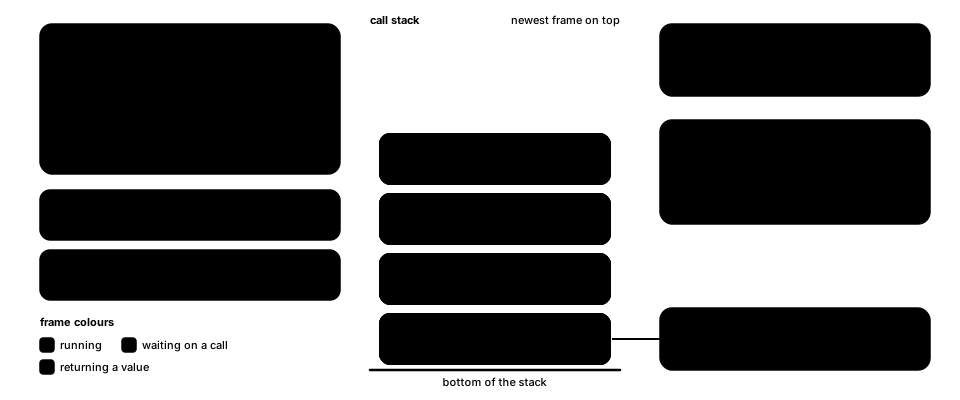
Recursion & the Call Stack
function เรียกตัวเองด้วย input ที่เล็กลง แต่ละ call รออยู่บน stack จน base case return แล้วคำตอบก็ unwind กลับขึ้นมาทีละชั้น
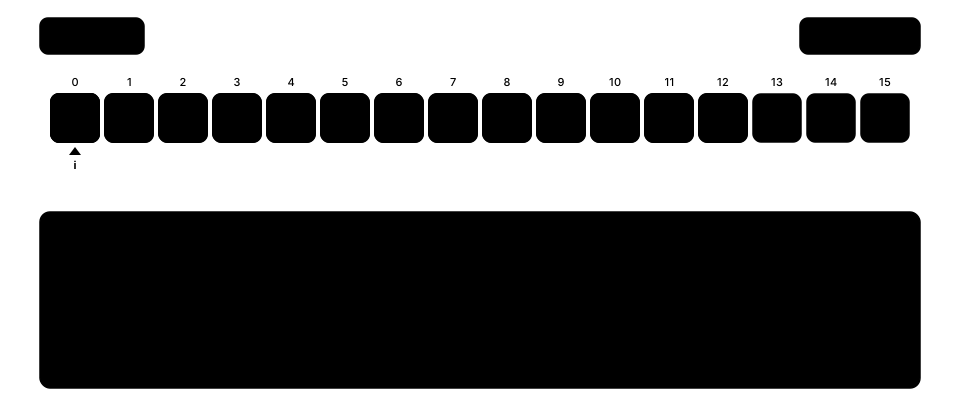
Binary Search
ตรวจแต่ละครั้งก็ตัดช่วงที่เรียงแล้วเหลือครึ่งเดียว: ราว 20 ขั้นก็หาตัวที่ต้องการเจอจาก 1 ล้านตัว ส่วนการไล่หาทีละตัวอาจต้องใช้ถึง 1 ล้านขั้น
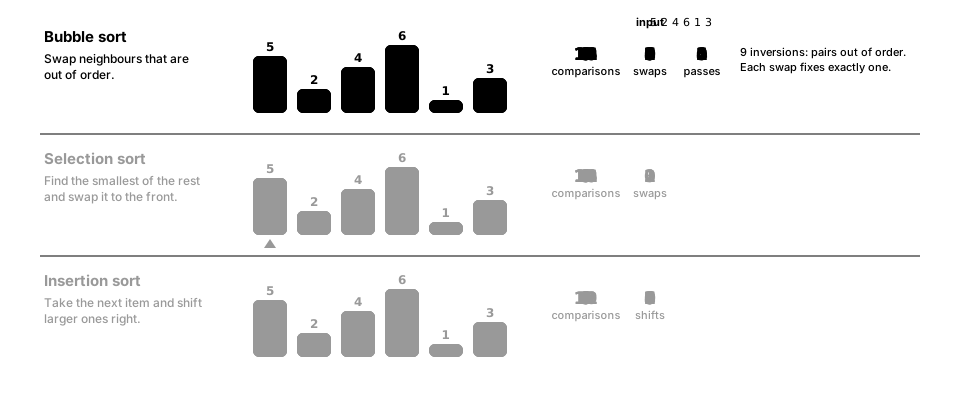
Bubble, Selection & Insertion Sort
เทียบ sort ง่าย ๆ สามตัวที่เป็น O(n²) แล้วดูว่าทำไม insertion sort ถึงยังทำงานอยู่ใน sort ตัวเร็วของ library ตอนเจอ run สั้น ๆ
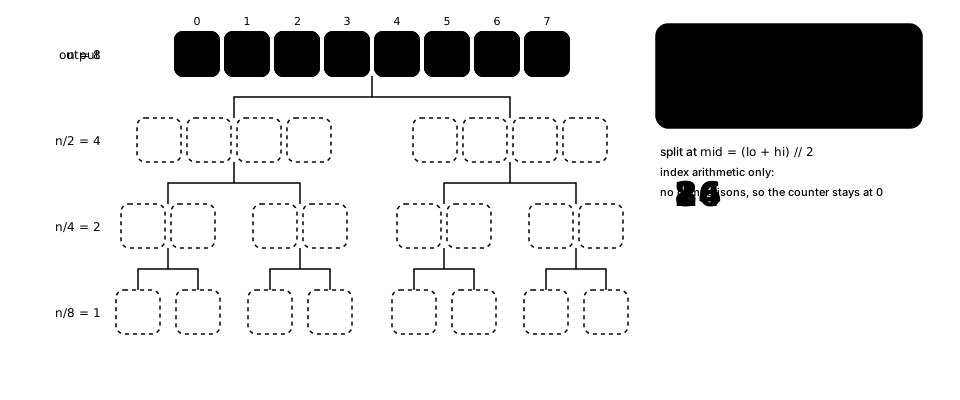
Merge Sort
แบ่ง list ไปเรื่อย ๆ จนเหลือทีละตัว แล้ว merge ครึ่งที่เรียงแล้วกลับเข้าด้วยกัน: O(n log n) ทุกครั้ง แถมยัง stable
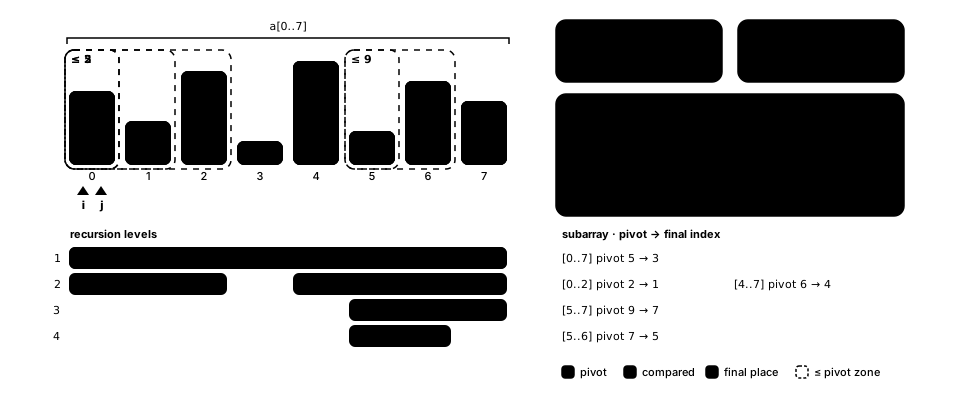
Quicksort
partition โดยใช้ pivot ให้ค่าที่เล็กกว่าไปอยู่ซ้าย ค่าที่ใหญ่กว่าไปอยู่ขวา แล้ว sort แต่ละฝั่ง: เร็วและทำแบบ in place ได้ แต่ถ้าเลือก pivot ไม่ดีก็กลายเป็น O(n²)
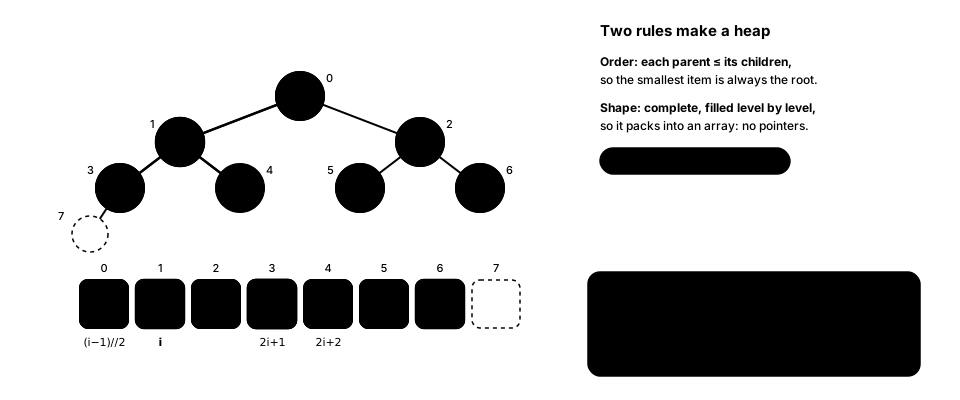
Binary Heap & Heapsort
complete binary tree ที่อัดลงใน array แล้วเก็บตัวที่เล็กที่สุดไว้บนสุด: push กับ pop ใช้ O(log n) เป็น priority queue ตัวคลาสสิก
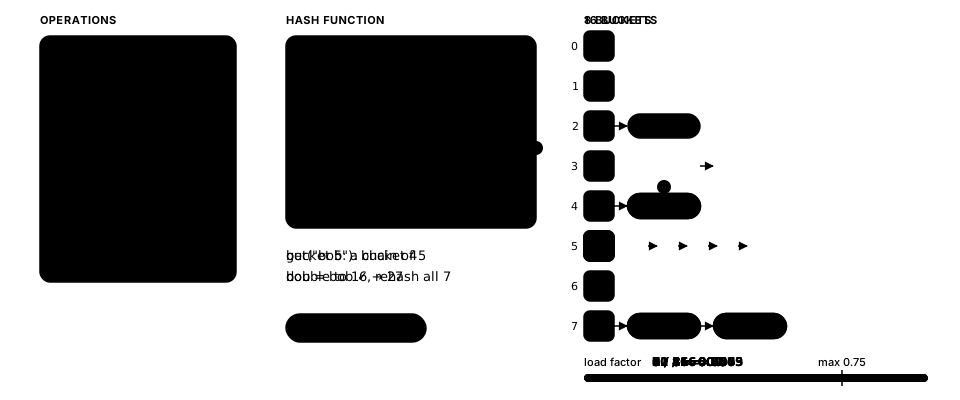
Hash Table
hash แต่ละ key ตรงไปที่ bucket ทำให้ lookup เฉลี่ยเป็น O(1) key ที่ชนกันก็ใช้ bucket ร่วมกัน และพอเริ่มเต็ม table ก็ขยายตัว
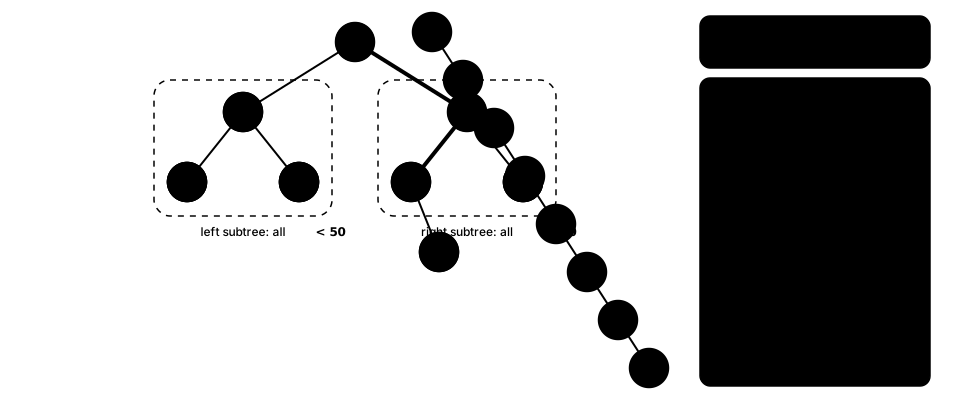
Binary Search Tree
key ที่เล็กกว่าไปซ้าย ที่ใหญ่กว่าไปขวา: search กับ insert เป็น O(log n) ตอนที่ tree ยังสมดุลอยู่ แต่พอ tree เบี้ยวจนกลายเป็น list ก็เป็น O(n)
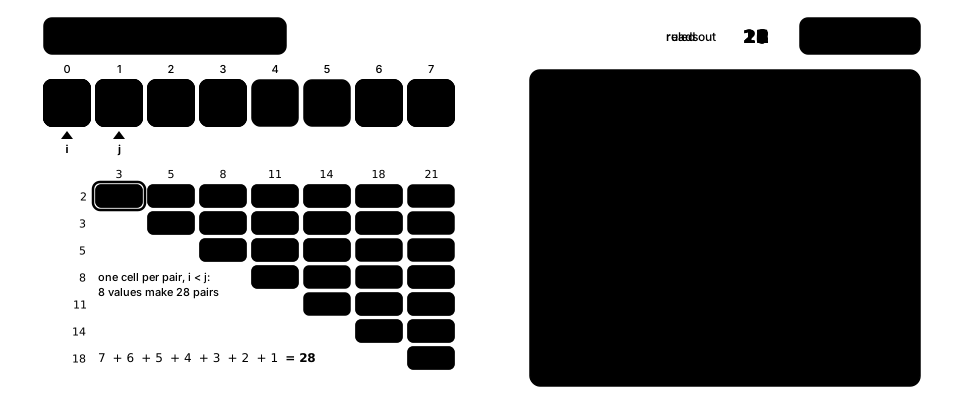
Two Pointers
เลื่อน index สองตัวไปบน array จะเดินเข้าหากันหรือให้ตัวหนึ่งไล่ตามอีกตัวก็ได้ แก้โจทย์เรื่องคู่และการ partition จบในรอบเดียว
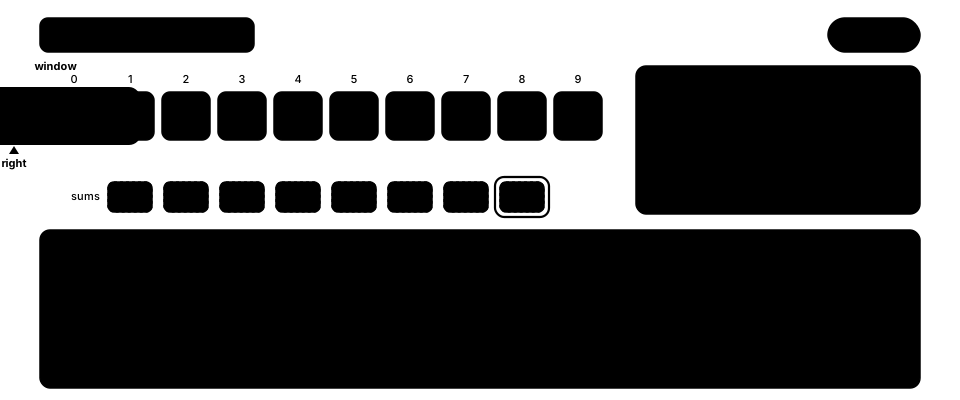
Sliding Window
เลื่อน window ไปตามลำดับข้อมูล เพิ่มตัวที่เข้ามา ทิ้งตัวที่ออกไป แทนที่จะไล่ดูใหม่ทุก window
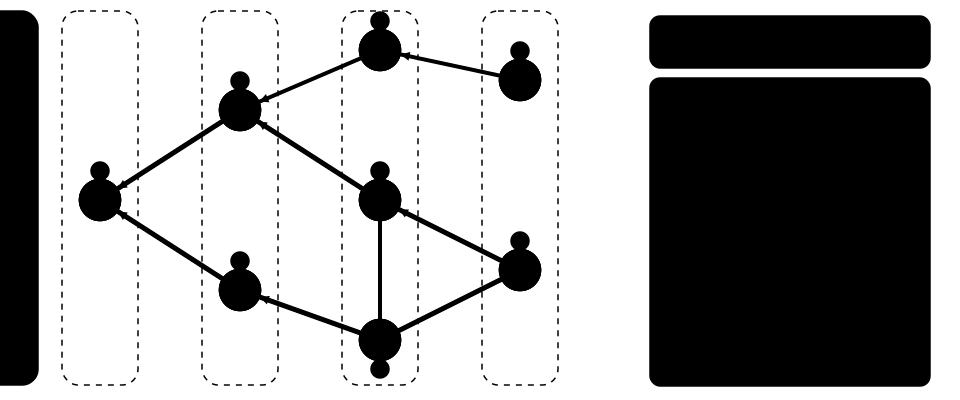
Breadth-First Search
ไล่สำรวจกราฟทีละชั้นด้วย queue พอ BFS ไปถึง node ไหนเป็นครั้งแรก ก็แปลว่าเจอ path ที่ใช้ edge น้อยที่สุดไป node นั้นแล้ว
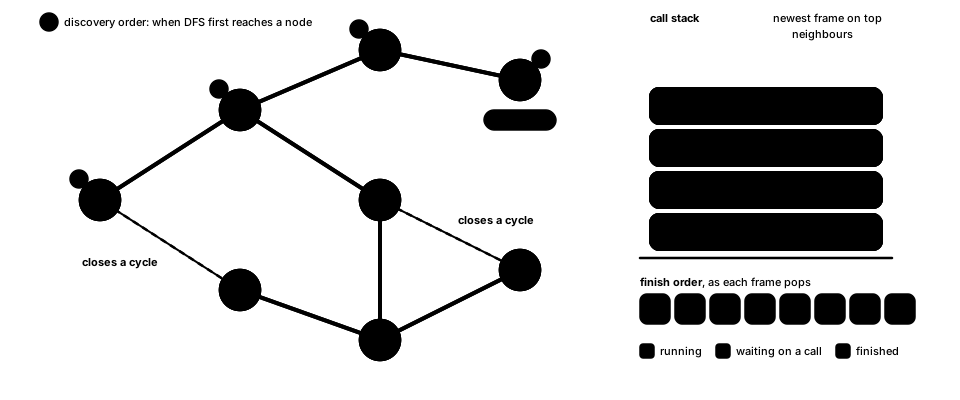
Depth-First Search
เดินตาม path เดียวให้ลึกสุดเท่าที่ไปได้ แล้วค่อย backtrack มี stack หรือ recursion คอยจำว่าจะกลับไปทำต่อตรงไหน แถมยังใช้หา cycle ได้ด้วย
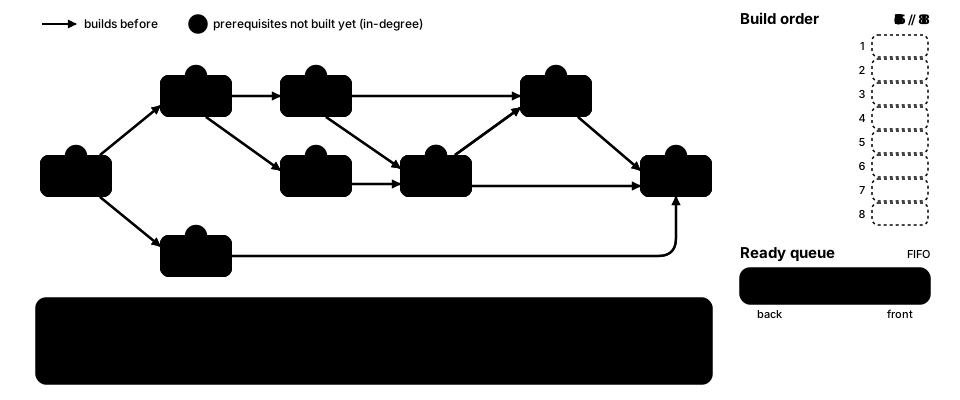
Topological Sort
เรียงงานให้ทุก dependency มาก่อนสิ่งที่ต้องใช้มัน แบบที่ build tool กับ package manager ทำ ถ้ามี cycle ก็เรียงไม่ได้เลย
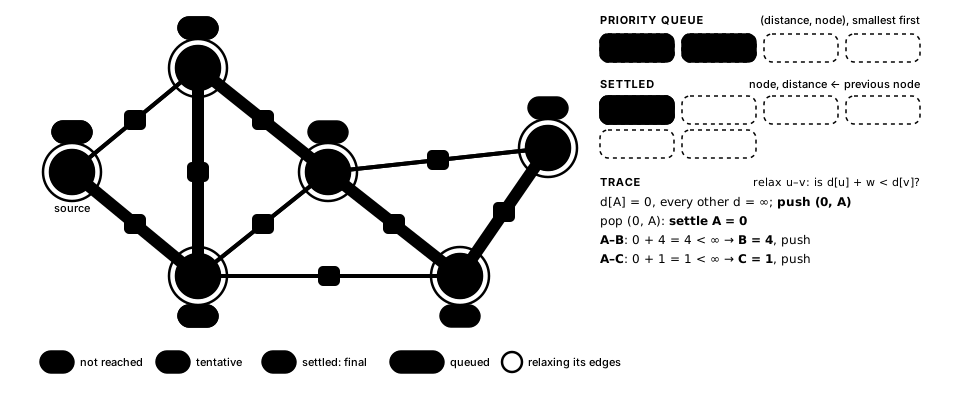
Dijkstra's Shortest Path
เลือก node ที่ใกล้ที่สุดที่ยังไม่ได้ settle มา settle แล้ว relax edge ของมัน ทำซ้ำไปเรื่อย ๆ: ได้ shortest path จาก source เดียว ถ้าไม่มี edge ไหน weight ติดลบ
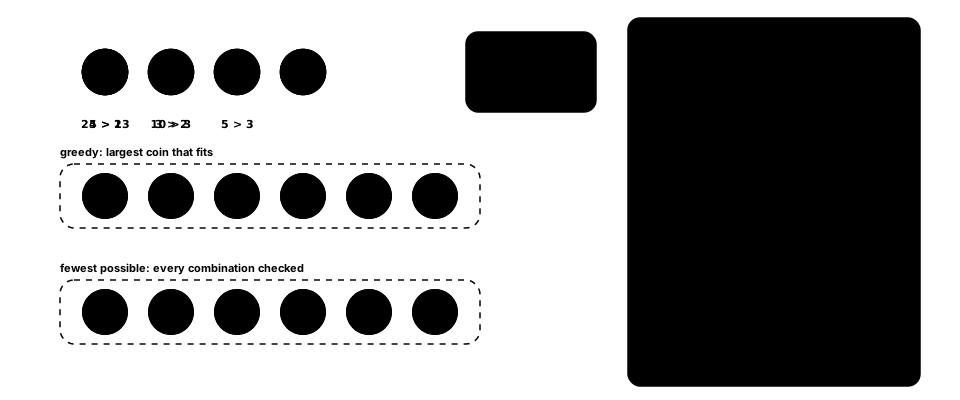
Greedy Algorithms
เลือกทางที่ดูดีที่สุดตอนนี้แล้วไม่ย้อนกลับมาแก้อีก: บางโจทย์ได้คำตอบ optimal แต่บางโจทย์ก็ผิดแบบเงียบ ๆ
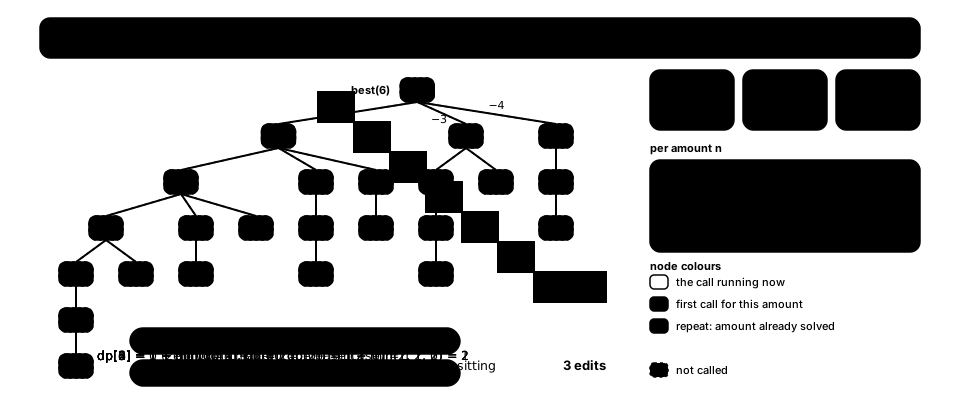
Dynamic Programming
แก้ subproblem ที่ซ้อนทับกันแต่ละตัวแค่ครั้งเดียว แล้วเอาคำตอบกลับมาใช้ซ้ำ จะทำแบบ top-down ด้วย memoization หรือ bottom-up ด้วยตารางก็ได้
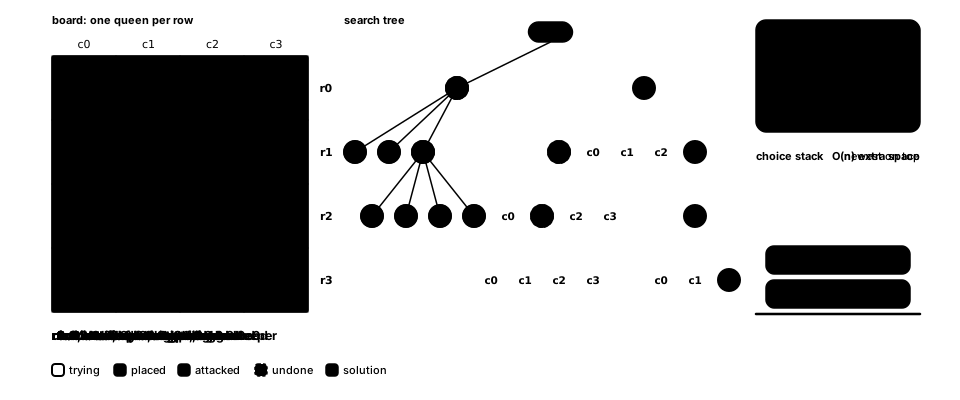
Backtracking
ค่อย ๆ สร้างคำตอบทีละตัวเลือก ถ้าตัวเลือกไหนพาไปเจอทางตันก็ undo: N-Queens, sudoku, permutation
Design Patterns (GoF)
23 แพตเทิร์นเชิงวัตถุสุดคลาสสิกจากหนังสือ Gang of Four: สร้าง object ประกอบ object และให้ object ทำงานด้วยกันยังไง
Abstract Factory
สร้าง object ที่เกี่ยวข้องกันเป็นตระกูลผ่าน interface เดียว จะสลับทั้งตระกูลเมื่อไรก็ไม่ต้องแตะโค้ดของ client เลย
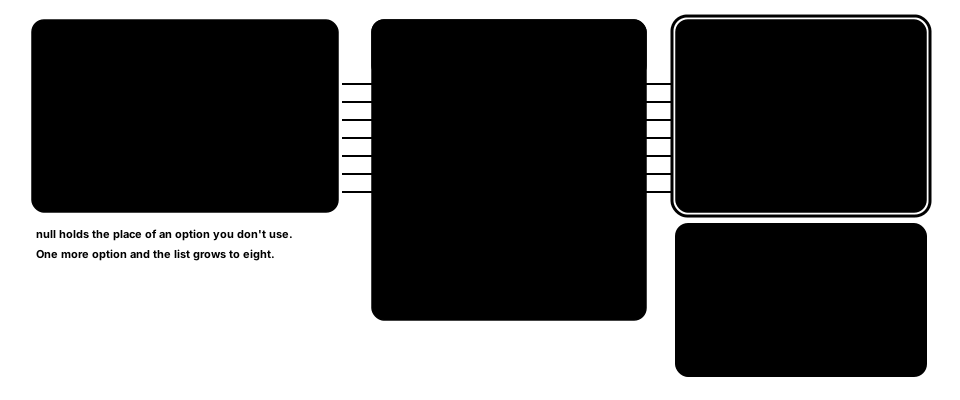
Builder
ค่อย ๆ ประกอบ object ที่ซับซ้อนทีละขั้น แล้วเช็กความถูกต้องทีเดียวตอนท้าย แทนที่จะเรียก constructor ที่มี argument สิบตัว
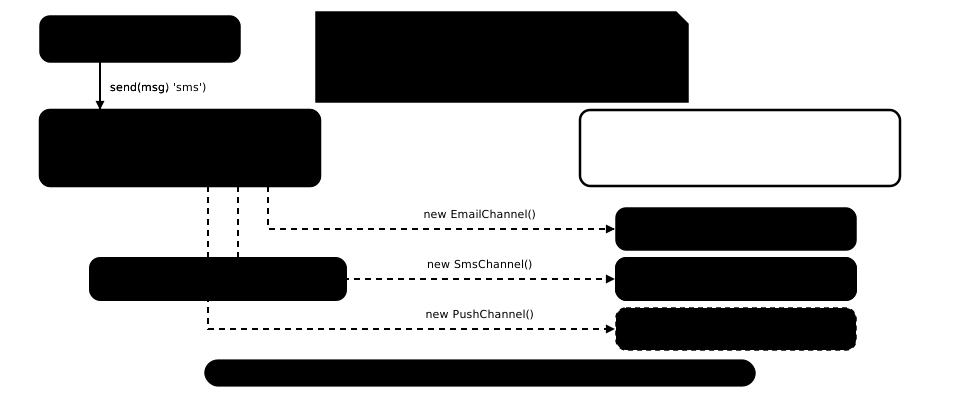
Factory Method
ให้ subclass เลือกเองว่าจะสร้าง class ไหน: base class เขียนโค้ดผ่าน interface แล้วเรียก method สร้าง object ที่ override ได้

Prototype
สร้าง object ใหม่ด้วยการคัดลอก prototype ที่ตั้งค่าไว้แล้ว แทนที่จะสร้างจากศูนย์ และรู้ด้วยว่าตอนไหนต้องคัดลอกแบบ deep copy
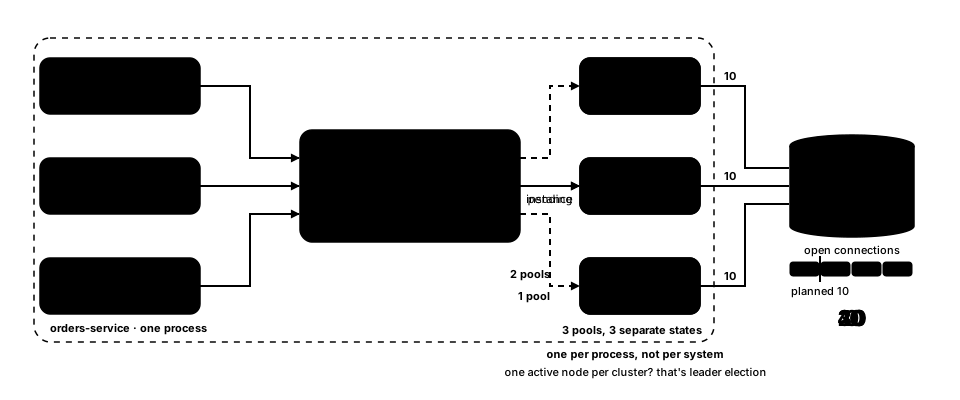
Singleton
ให้มีแค่ instance เดียวแน่นอน พร้อมทางเข้าแบบ global และทำไมการ inject instance เดียวที่ใช้ร่วมกันถึงมักตอบโจทย์นี้ได้ดีกว่า
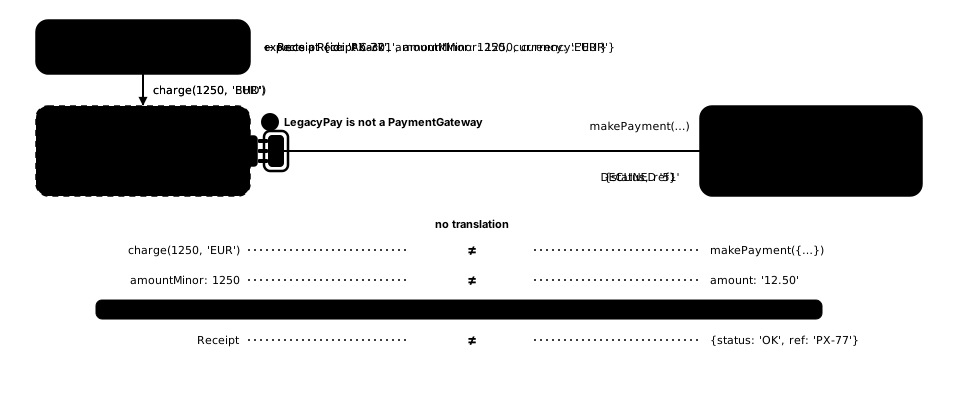
Adapter
ห่อ interface ที่เข้ากันไม่ได้ ให้โค้ดเดิมใช้ได้เลยโดยไม่ต้องแก้: ทางแก้คลาสสิกเวลาเจอ API ของ third-party หรือระบบ legacy
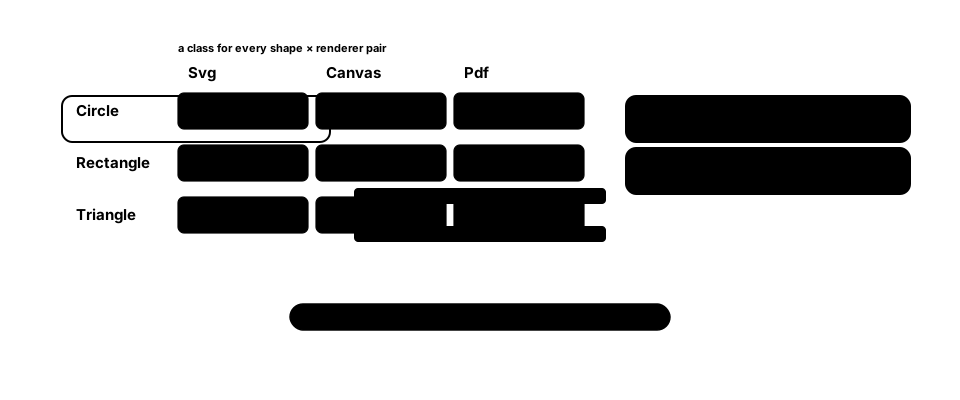
Bridge
แยก abstraction ออกจาก implementation ให้สองฝั่งเปลี่ยนได้อิสระจากกัน: shape m แบบกับ renderer n แบบก็ใช้ class แค่ m + n ตัว ไม่ใช่ m × n
Composite
ใช้งาน object เดี่ยว ๆ กับกลุ่มของ object ผ่าน interface เดียวกัน ทั้ง tree เลยตอบคำถามได้แบบเดียวกับ leaf ตัวเดียว
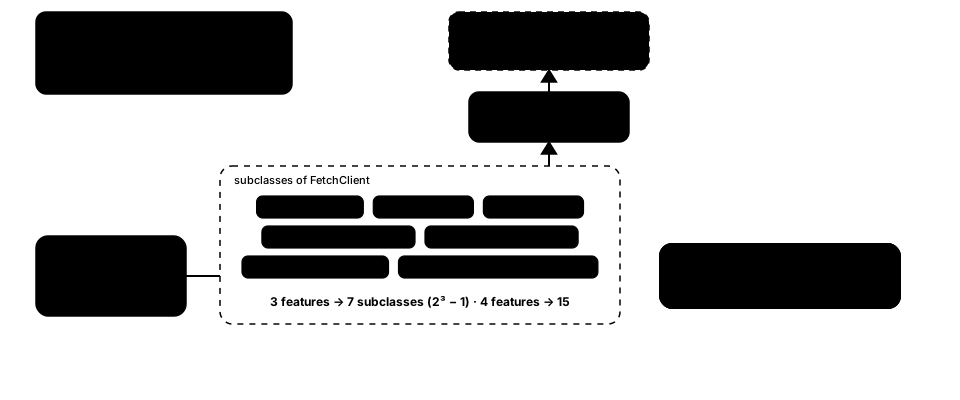
Decorator
ห่อ object เพื่อเพิ่มพฤติกรรมตอน runtime ซ้อน wrapper ไปทีละชั้น แทนที่จะสร้าง subclass เพิ่มขึ้นเรื่อย ๆ ให้ครบทุกชุดผสม
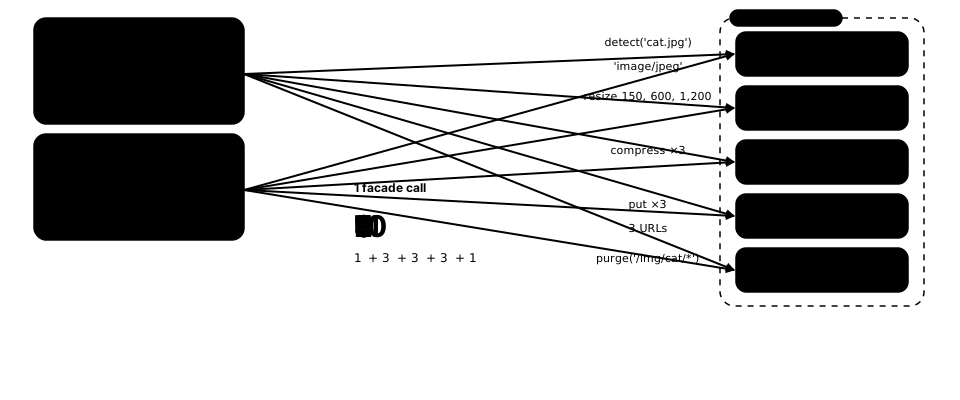
Facade
ให้ subsystem ที่ซับซ้อนมีทางเข้าง่าย ๆ แค่ทางเดียว caller จะได้เรียกครั้งเดียว ไม่ต้องคอยประสานงานหลาย class เอง
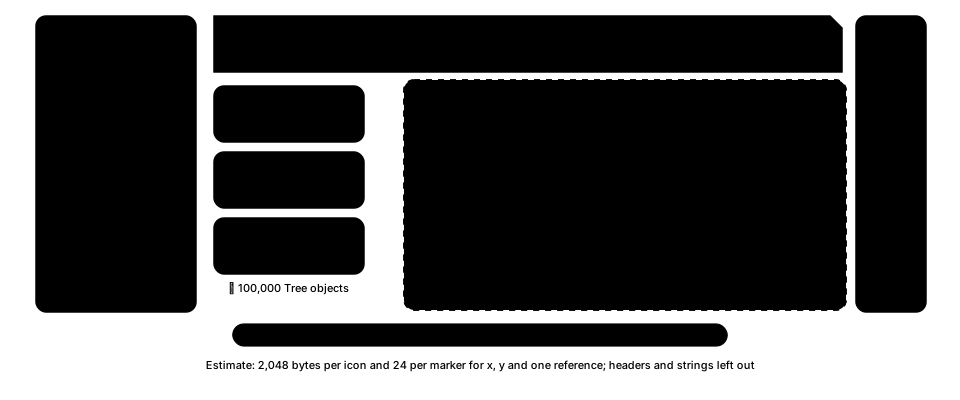
Flyweight
แชร์ส่วนที่เหมือนกันและเป็น immutable ของ object ที่คล้าย ๆ กันจำนวนมาก แล้วให้แต่ละตัวเก็บแค่ส่วนที่ต่าง จะได้ประหยัด memory
Proxy
เป็นตัวแทนของ object อื่นด้วย interface เดียวกัน เพื่อคุมการเข้าถึง object นั้น: lazy loading, caching, เช็กสิทธิ์ และ remoting
Chain of Responsibility
ส่ง request ต่อไปตามสายของ handler จนกว่าจะมีตัวหนึ่งรับไปจัดการ ผู้ส่งจะได้ไม่ต้องรู้เลยว่าตัวไหนจะเป็นคนรับ
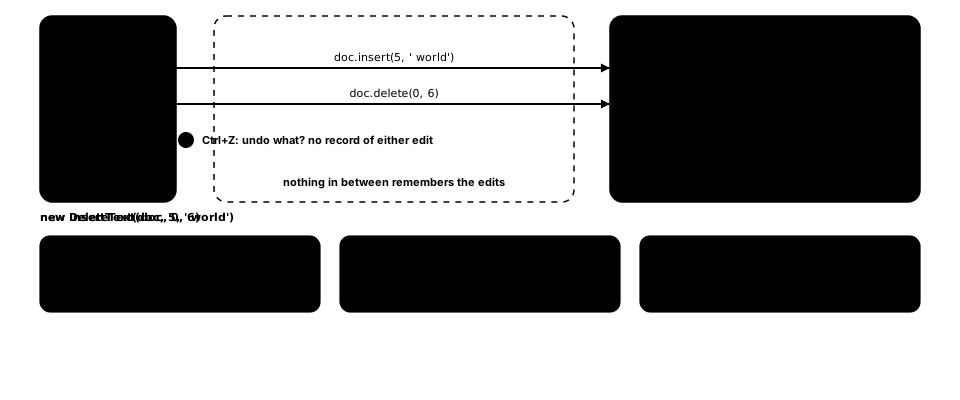
Command
เปลี่ยน request ให้เป็น object ที่เอาไปเข้า queue, เก็บ log, undo และ redo ได้ แล้วก็แยกคนสั่งออกจากคนลงมือทำ
Interpreter
เขียน grammar ของภาษาเล็ก ๆ เป็น class แล้ว evaluate ประโยคด้วยการเดินไปตาม syntax tree ของมัน
Iterator
ไล่ดู collection ทีละ element โดยไม่เปิดให้เห็นว่าข้างในเก็บไว้ยังไง: จะเป็น array, tree หรือ stream ที่ไม่มีวันจบก็ได้
Mediator
ให้ object คุยกันผ่าน mediator ตัวเดียว dependency แบบ many-to-many ก็จะเหลือแค่ one-to-many
Memento
เก็บ state ของ object ไว้ใน snapshot ที่มีแค่ตัวมันเองอ่านได้ จะได้กู้คืนทีหลังได้โดยไม่ทำลาย encapsulation
Observer
subject แจ้ง observer ทุกตัวที่ subscribe ไว้ทุกครั้งที่มีอะไรเปลี่ยน เปลี่ยนครั้งเดียวก็ update ตัวที่ขึ้นกับมันได้หลายตัว โดยที่ subject ไม่ต้องเอ่ยชื่อตัวไหนเลย
State
ให้ object เปลี่ยนพฤติกรรมเมื่อ state ของมันเปลี่ยน โดยส่งงานต่อให้ state object แทนที่จะปล่อยให้ switch statement ยาวขึ้นเรื่อย ๆ
Strategy
เอาอัลกอริทึมที่สลับกันได้ไปไว้หลัง interface เดียว แล้วเลือกใช้สักตัวตอน runtime แทนที่จะแตก branch อยู่ใน caller
Template Method
วางโครงของอัลกอริทึมไว้ใน base class แล้วให้ subclass เติมแต่ละขั้นเอง โดยไม่เปลี่ยนลำดับของขั้นตอน
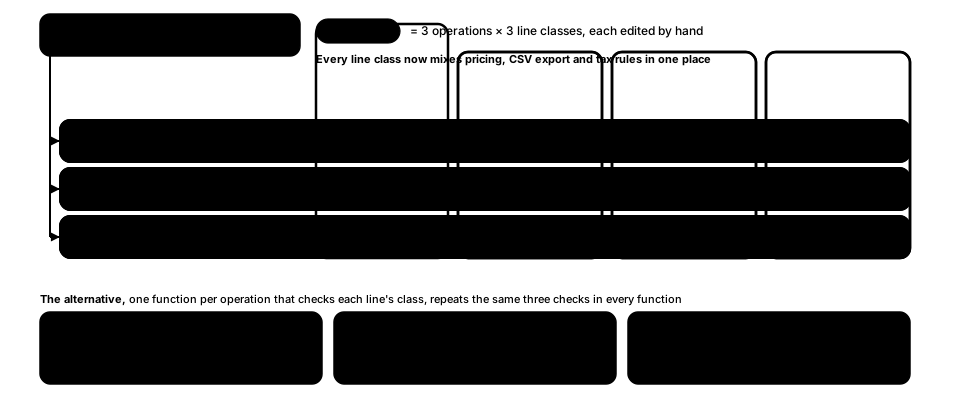
Visitor
เพิ่ม operation ใหม่ให้ชุด class ที่นิ่งแล้วได้โดยไม่ต้องแก้ class พวกนั้น: แต่ละ operation คือ visitor ที่ทุก element รับ (accept) เข้ามา
ส่วนประกอบของระบบ
ของสำเร็จรูปที่ใช้ประกอบระบบจริง: แต่ละตัวทำงานข้างในยังไง อยู่ตรงไหนของ solution และควรเลือกใช้ตอนไหน
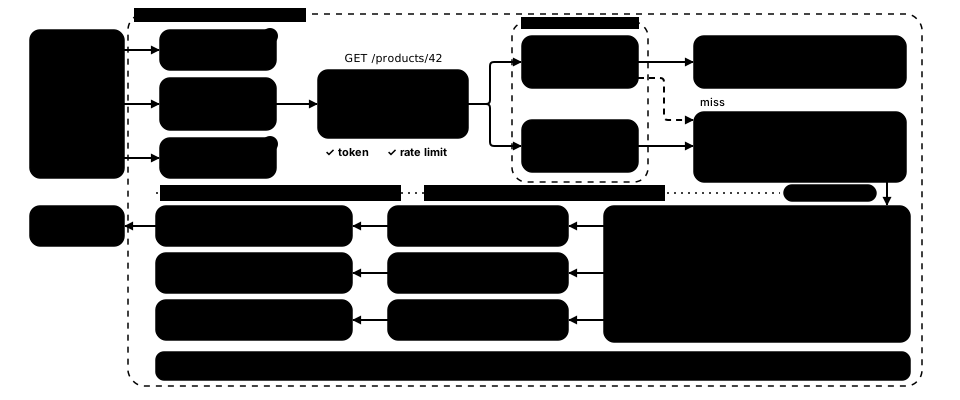
System Map
ตาม request หนึ่งตัวกับ event หนึ่งตัวผ่านระบบทั่ว ๆ ไป: DNS, CDN, load balancer, gateway, service, cache, database, queue และ search
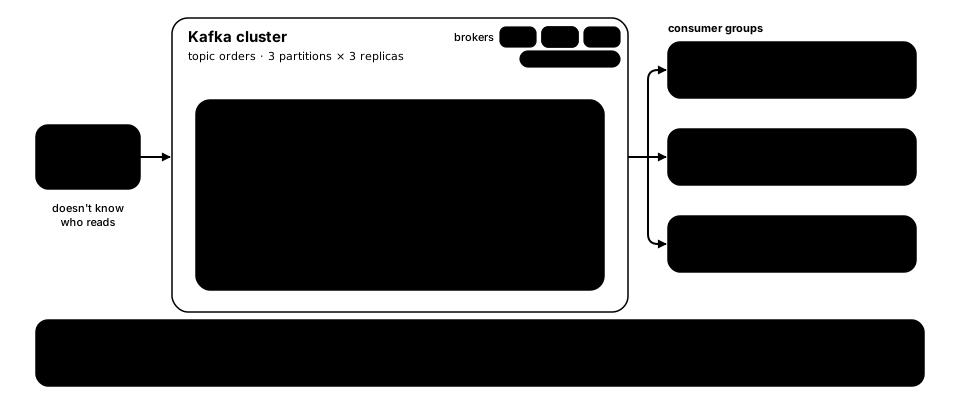
Apache Kafka
commit log ที่แบ่ง partition และมี replica: producer ต่อ event ท้าย log ส่วน consumer group อ่านตามจังหวะของตัวเอง และ replay ย้อนหลังได้
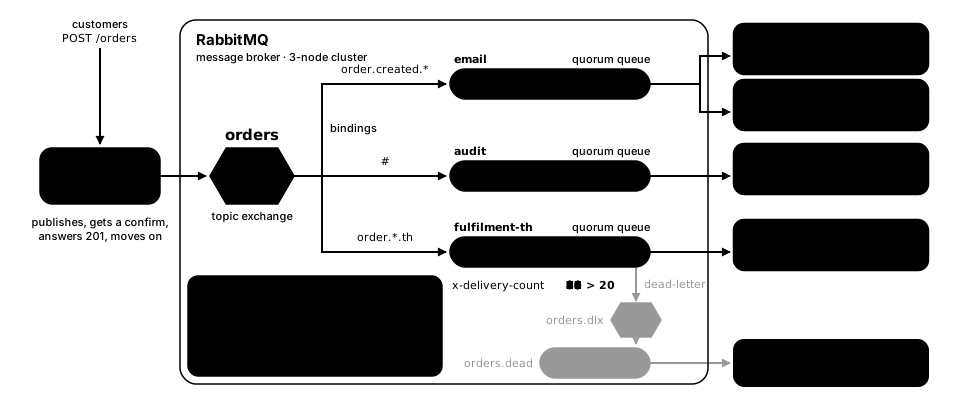
RabbitMQ
message broker: exchange route message แต่ละตัวเข้า queue แล้ว consumer ก็ถือมันไว้จนกว่าจะ acknowledge หรือ reject
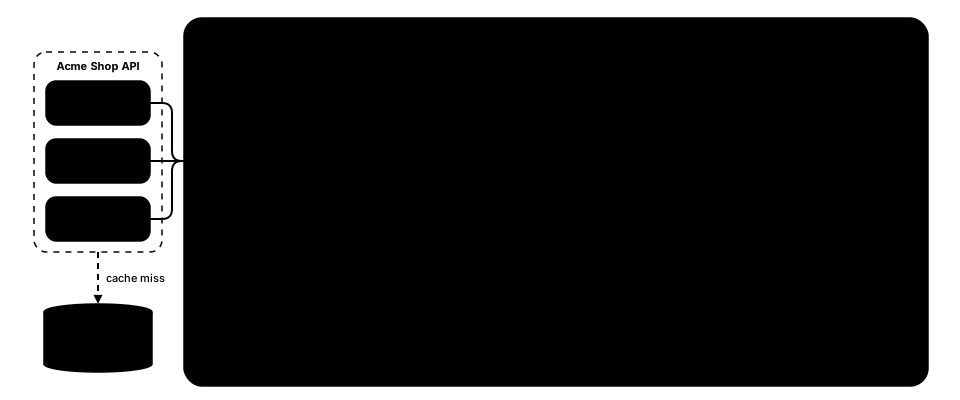
Redis & Valkey
server ที่เก็บ data structure ไว้ใน memory: เป็นทั้ง cache, session store, rate limiter, leaderboard และ queue แบบเบา ๆ ใน process เดียว
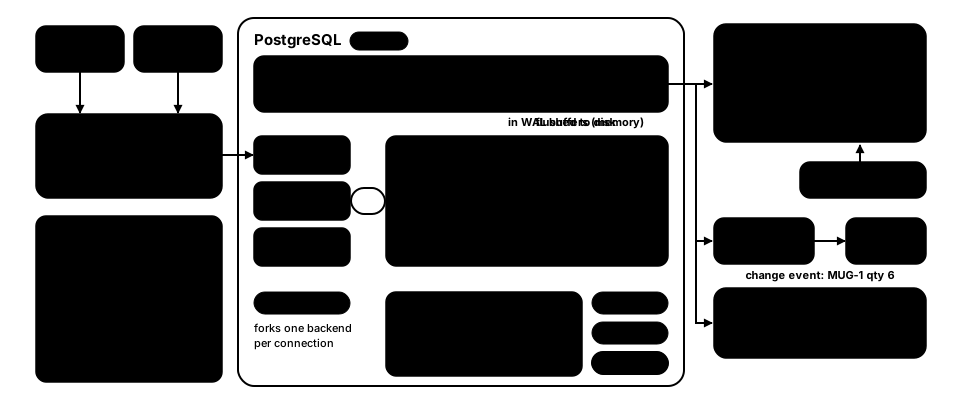
PostgreSQL
relational database: ACID transaction ด้วย MVCC มี write-ahead log ไว้ทำ durability และ replication มี SQL และ index ให้เลือกหลายแบบ
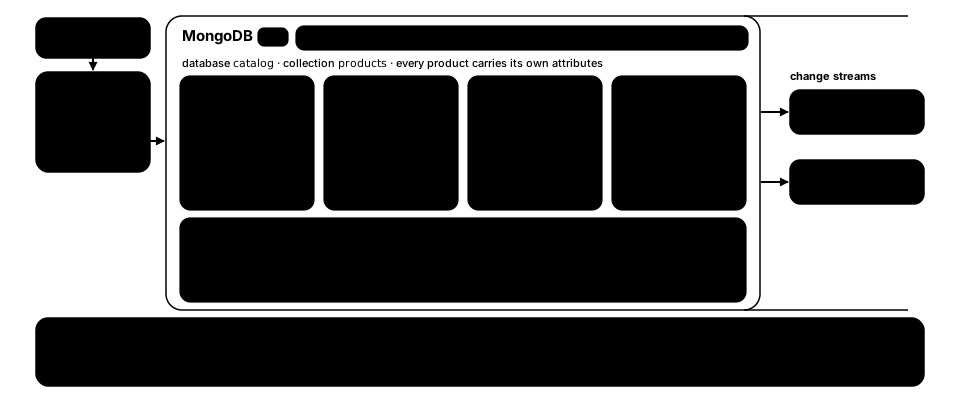
MongoDB
document database: document แบบคล้าย JSON ที่ schema ยืดหยุ่น, replica set สำหรับ failover และ sharding สำหรับ scale out
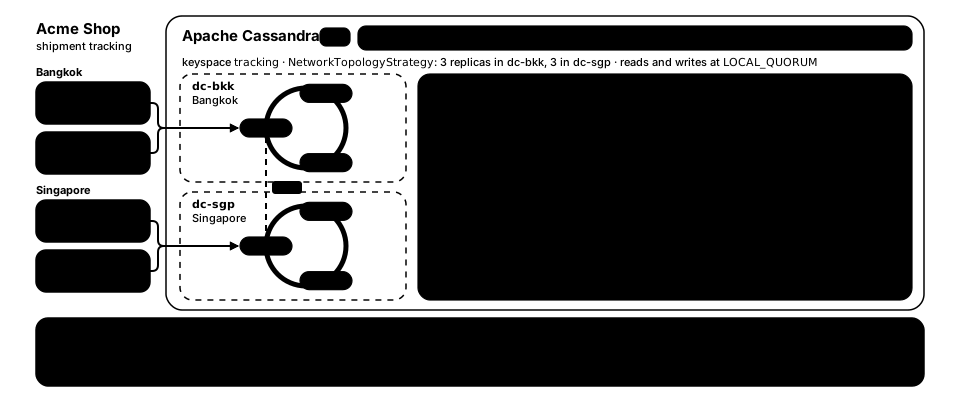
Apache Cassandra
database แบบ wide-column ที่สร้างมารับการเขียนหนัก ๆ ข้ามหลาย data centre: มี token ring, consistency ที่ปรับได้ และ storage แบบ LSM
Elasticsearch & OpenSearch
search engine ที่สร้างบน inverted index: full-text query ที่จัดอันดับตาม relevance และ aggregation บน index ที่แบ่ง shard
NGINX
reverse proxy และ web server: ทำ TLS termination, load balancing, caching และ rate limiting ไว้หน้าแอปพลิเคชัน
Docker & Containers
แพ็กแอปกับ dependency ของมันเป็น image แล้วรันเป็น process ที่แยกตัวออกมา: layer, registry, namespace และ cgroup
Kubernetes
container orchestrator: เราประกาศ desired state ไว้ แล้ว controller ก็คอยดูแลให้ pod ถูก schedule ทำงานปกติ และเข้าถึงได้
etcd
key-value store บน Raft ที่ consistent แบบเข้มงวด ให้ cluster ต่าง ๆ ใช้เก็บ configuration, ทำ service discovery, lock และ leader election
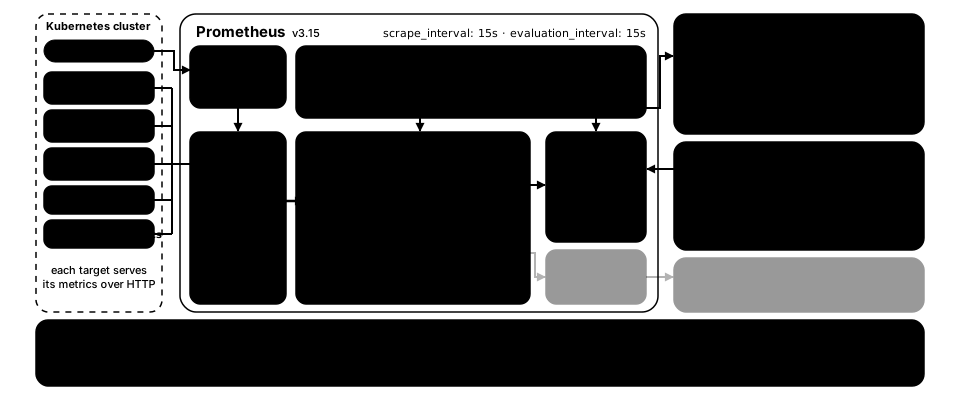
Prometheus & Grafana
monitoring แบบ pull: scrape metric เข้า time-series database แล้ว query ด้วย PromQL ตั้ง alert และทำกราฟใน Grafana
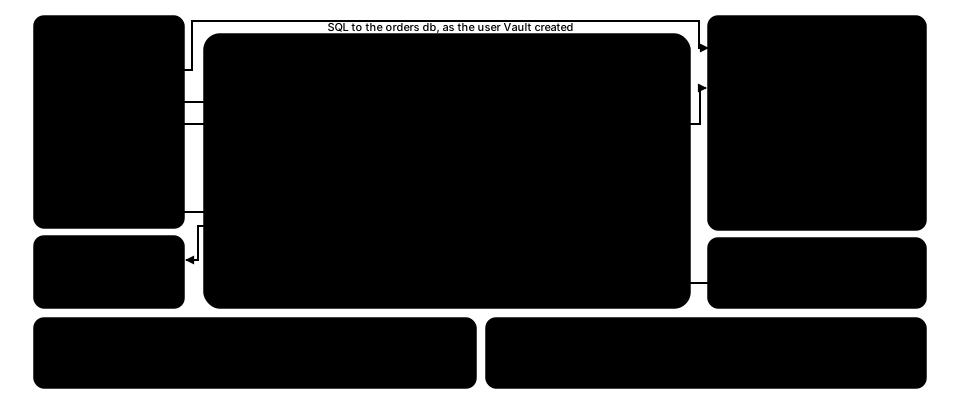
HashiCorp Vault
secrets manager: ยืนยันตัวตน workload แจก credential อายุสั้น เข้ารหัสข้อมูล และเก็บ audit ทุกการเข้าถึง
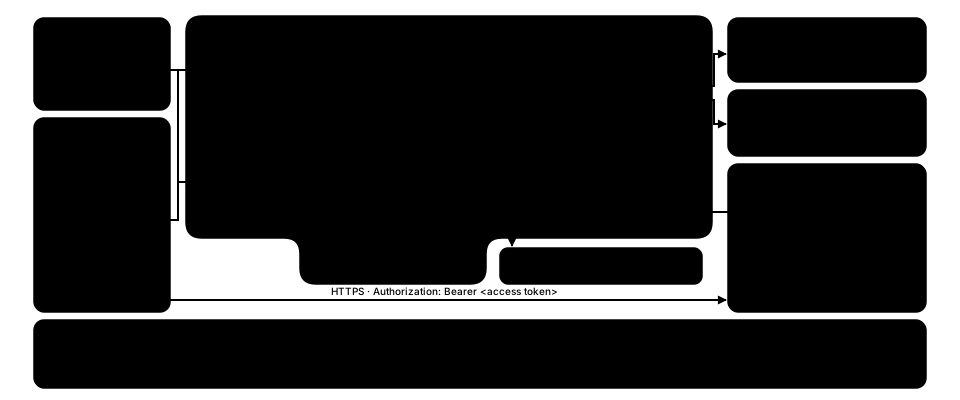
Keycloak
identity provider แบบ open source: ให้ผู้ใช้ sign in ทำ federation และ single sign-on แล้วออก token แบบ OpenID Connect และ SAML
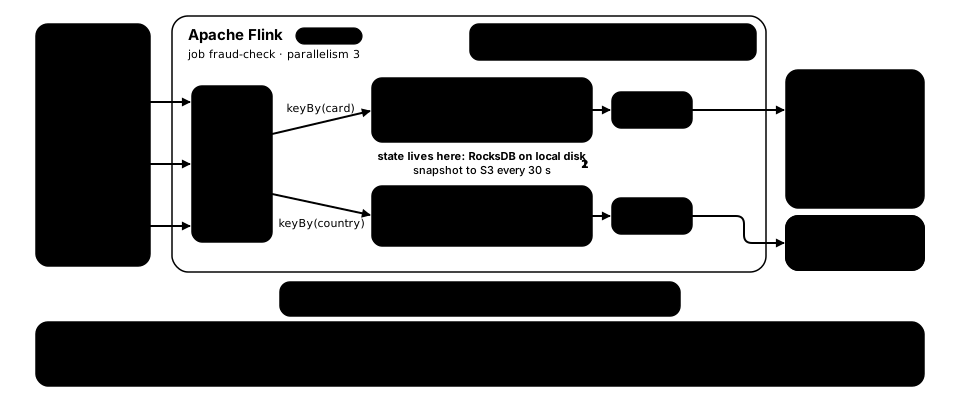
Apache Flink
stream processor: operator ที่มี state ทำงานบน stream ที่ไม่มีวันจบ พร้อม event time, window และ checkpoint แบบ exactly-once
บริการของ AWS
บริการ managed ของ Amazon Web Services: แต่ละตัวทำงานยังไง รับงานส่วนไหนไปจากเรา และเอามาต่อกันเป็น solution ยังไง
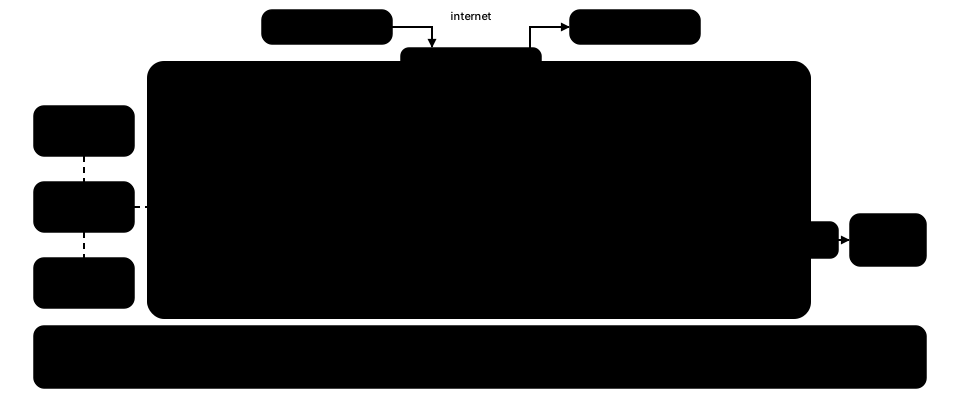
Amazon VPC
network ส่วนตัวของเราใน AWS: มี subnet ในแต่ละ Availability Zone, route table, gateway, security group และ endpoint
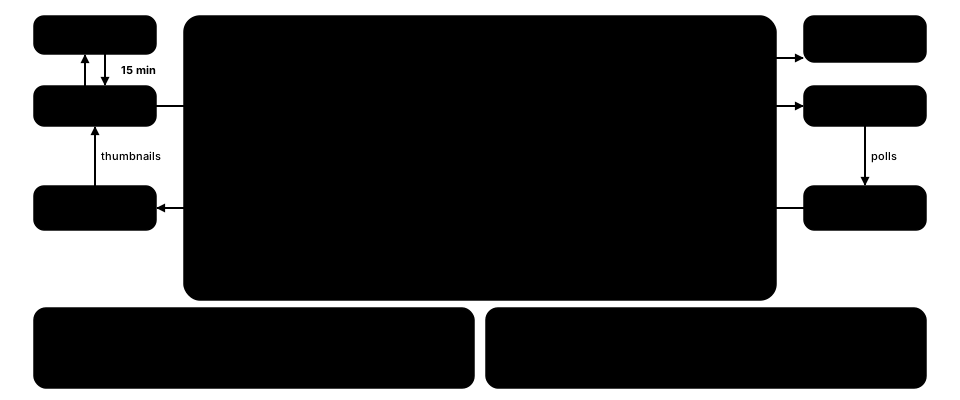
Amazon S3
Object storage: เก็บ object ไว้ใน bucket เรียกด้วย key กระจายเก็บข้าม Availability Zone และมี storage class, versioning กับ event ให้ใช้
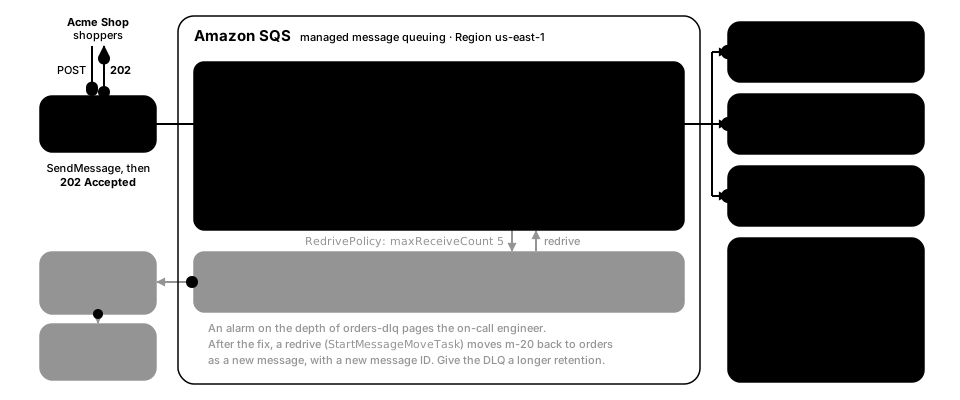
Amazon SQS
message queue แบบ managed: consumer เป็นฝ่าย poll, visibility timeout ซ่อน message ที่กำลังทำอยู่ และ message ที่พังซ้ำ ๆ จะไปที่ dead-letter queue
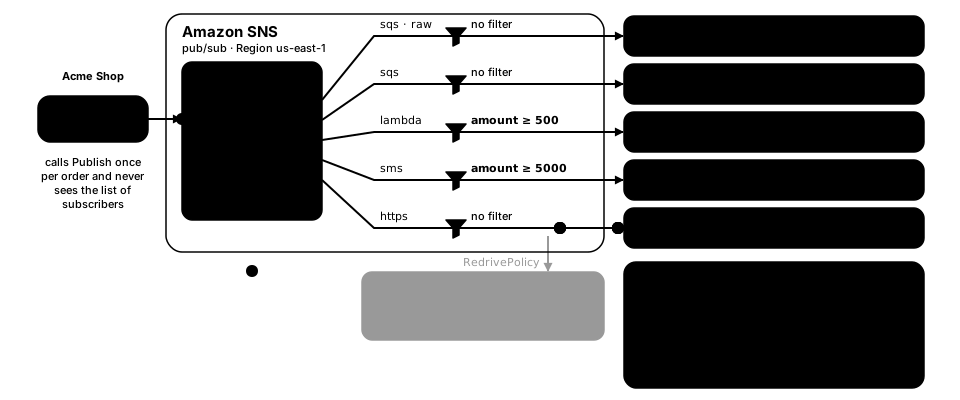
Amazon SNS
publish-subscribe แบบ managed: message ที่ publish ไปที่ topic จะกระจายออกไปที่ queue, function, HTTP endpoint, อีเมล และ SMS
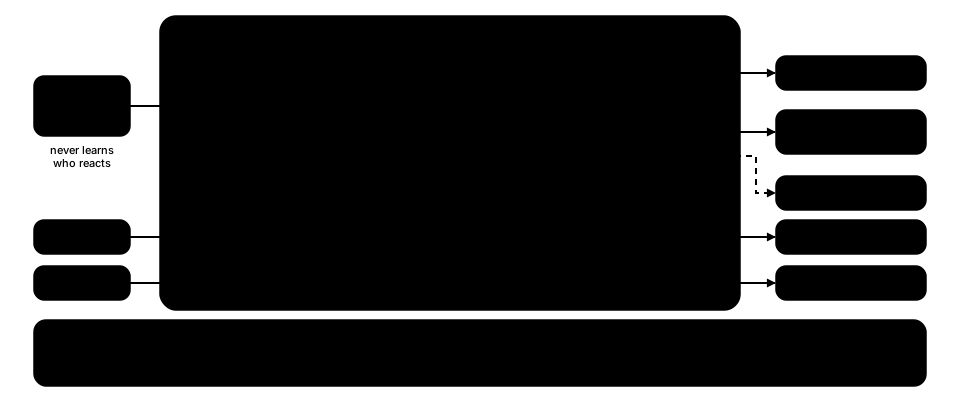
Amazon EventBridge
event bus: rule จะ match event จาก AWS service, SaaS app และโค้ดของเราเองตาม content แล้ว route ไปหา target
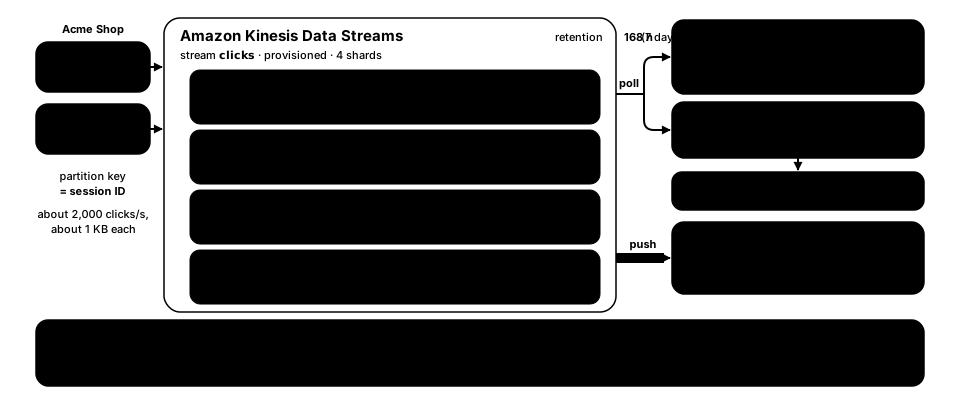
Amazon Kinesis Data Streams
streaming แบบ managed: record ไปลง shard ตาม partition key แล้ว consumer ก็อ่านแต่ละ shard ตามลำดับ และ replay ย้อนหลังได้
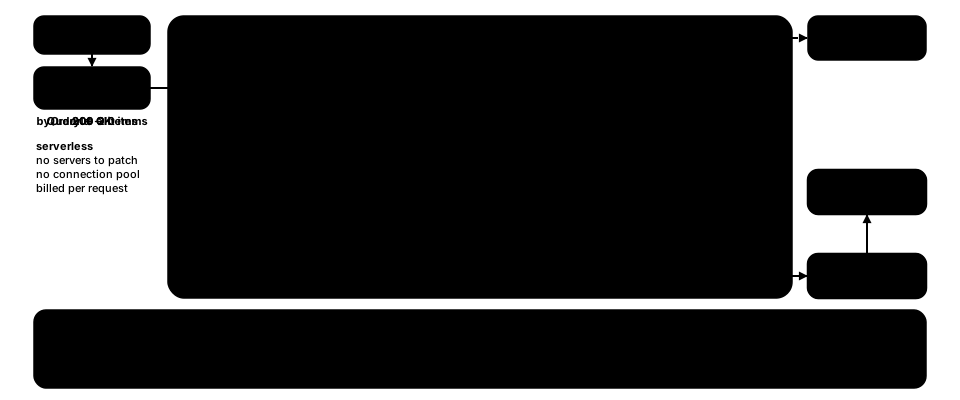
Amazon DynamoDB
database แบบ key-value และ document ที่เป็น serverless: partition key กระจาย item ไปตาม partition เพื่อให้อ่านได้ในระดับ millisecond หลักเดียว
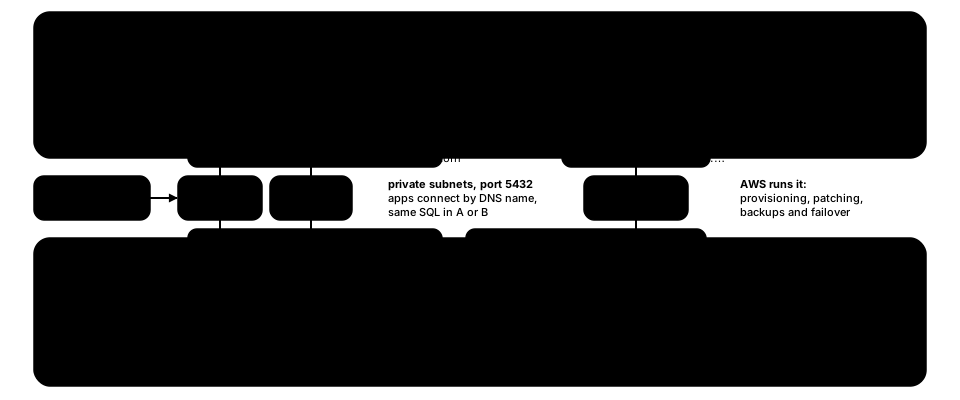
Amazon RDS & Aurora
relational database แบบ managed: backup, Multi-AZ failover และ read replica รวมถึง storage ของ Aurora ที่ใช้ร่วมกันข้ามสาม zone
AWS Lambda
Functions as a service: โค้ดรันทีละ event ใน execution environment ที่ AWS ดูแลให้ และ scale out ตาม concurrency
AWS Step Functions
workflow ในรูป state machine: ทำงานตามลำดับ แยก branch, retry, รอ และรันขนานกันข้ามหลาย service โดยบันทึกทุก step ไว้
Amazon ECS & Fargate
รัน container บน AWS: task definition และ service ที่คอยให้ task รันอยู่หลัง load balancer บน EC2 หรือบน Fargate แบบ serverless
Amazon Route 53
DNS แบบ managed: hosted zone, routing policy (weighted, latency, failover, geolocation) และ health check
AWS IAM
ใครทำอะไรได้บ้างใน AWS: principal, policy และ role ที่แจก credential แบบชั่วคราว และวิธีที่ request หนึ่งถูกประเมิน
Amazon Cognito
sign-up และ sign-in สำหรับ user ของแอป: user pool ออก token แบบ OpenID Connect ส่วน identity pool เอา token นั้นไปแลกเป็น AWS credential
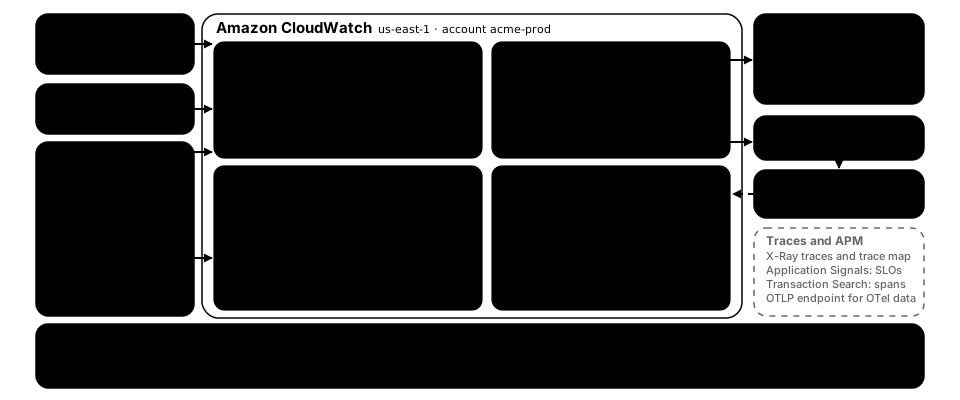
Amazon CloudWatch
metric, log, alarm และ dashboard ของ AWS resource และแอปของเรา รวมอยู่ใน monitoring service ตัวเดียว
ไม่เจอแพตเทิร์นที่ตรงกับคำนี้ ลองคำอื่นดู